Etiqueta: Normativa

  • Gobernanza de datos clínica: por qué el sector salud no puede improvisar

    Gobernanza de datos clínica: por qué el sector salud no puede improvisar

    Sin una gobernanza de datos robusta, los sistemas de salud no pueden garantizar ni la continuidad del cuidado del paciente ni el cumplimiento regulatorio. La discusión ya no es si implementarla, sino cómo construirla con los controles correctos en un sector donde un dato erróneo puede costar una vida.

    Los datos clínicos son, por naturaleza, fragmentados: provienen de historias clínicas electrónicas, dispositivos de monitoreo, laboratorios, farmacias y registros de seguros. Sin una capa de gobernanza que unifique definiciones, asigne ownership y garantice calidad, esa fragmentación se traduce directamente en diagnósticos incompletos, duplicación de estudios y errores de medicación. La atención centrada en el paciente —principio que hoy organiza los modelos de salud más avanzados— depende de que el dato correcto esté disponible, sea confiable y llegue en el momento oportuno.

    Qué falla cuando el dato clínico no tiene dueño

    El problema central en la mayoría de los sistemas hospitalarios no es la ausencia de datos, sino la ausencia de accountability sobre esos datos. En el marco DAMA-DMBOK, el concepto de data stewardship —la responsabilidad formal sobre un dominio de datos— es el núcleo operativo de cualquier programa de gobernanza. En salud, esa responsabilidad suele estar implícita en el médico tratante o en el área de sistemas, pero rara vez está formalizada: no hay un data steward clínico con criterios documentados, no hay un glosario de negocio que defina qué es “episodio de atención” o “diagnóstico principal”, y no hay un proceso de resolución de conflictos cuando dos fuentes dicen cosas distintas sobre el mismo paciente.

    El EDM Council, a través de su marco CDMC (Cloud Data Management Capabilities), identifica la gestión del ciclo de vida del dato como una de las capabilities críticas en entornos regulados. En salud, eso implica saber cuándo un dato nace, quién lo modifica, cuándo expira y bajo qué condiciones puede ser compartido con terceros. Sin data lineage trazable —es decir, sin poder seguir el recorrido completo de un dato desde su origen hasta su uso— cualquier auditoría clínica o regulatoria se convierte en un ejercicio de arqueología forense.

    Los marcos regulatorios en LATAM que presionan hacia la formalización

    América Latina no tiene un equivalente directo al HIPAA estadounidense, pero la presión regulatoria sobre datos de salud crece en toda la región. En Brasil, la Lei Geral de Proteção de Dados (LGPD, Lei nº 13.709/2018) clasifica los datos de salud como datos sensibles con requisitos de tratamiento más estrictos, incluyendo base legal explícita y medidas técnicas y organizativas específicas. La Autoridade Nacional de Proteção de Dados (ANPD) ya emitió orientaciones sobre cómo aplica la ley en contextos de salud pública. En Argentina, la Ley 25.326 de Protección de Datos Personales contempla categorías especiales para datos de salud, y la AAIP (Agencia de Acceso a la Información Pública) ha señalado reiteradamente que el sector salud es de atención prioritaria en sus planes de fiscalización. En México, la LFPDPPP y su reglamento establecen obligaciones específicas para quienes tratan datos de salud en el sector privado, con requerimientos de consentimiento expreso y medidas de seguridad reforzadas.

    Lo que estas regulaciones tienen en común es que no se satisfacen con declaraciones de política interna: exigen evidencia de controles operativos, lo que implica —en la práctica— un programa de gobernanza de datos funcionando. Una organización de salud que no puede demostrar quién autorizó el acceso a un expediente, qué datos comparte con qué terceros y bajo qué base legal, está expuesta a sanciones independientemente de si hubo o no una brecha.

    Cuándo aplica la gobernanza clínica / cuándo NO alcanza con política de privacidad

    La gobernanza de datos en salud aplica en cualquier contexto donde se tomen decisiones clínicas, operativas o estratégicas basadas en datos de pacientes: hospitales, clínicas, aseguradoras de salud, laboratorios, plataformas de telemedicina y proveedores de sistemas de información hospitalaria (HIS/EMR). No aplica solo al área de IT: la gobernanza es un programa de negocio con responsabilidades distribuidas entre clínicos, administradores y equipos de datos. Una política de privacidad publicada en el sitio web no reemplaza ni sustituye un programa de gobernanza: la política declara intenciones, la gobernanza implementa controles verificables. Tampoco alcanza con tener un DPO (Delegado de Protección de Datos) designado si ese rol no cuenta con las estructuras de datos bien definidas para ejercer sus funciones.

    Tres capabilities que un CDO de salud debe priorizar este trimestre

    • Catálogo de datos clínicos activo: un inventario de los dominios de datos críticos (paciente, episodio, diagnóstico, medicamento, resultado) con ownership asignado y definiciones acordadas entre clínicos y equipos de datos. Sin catálogo, no hay punto de partida para ninguna iniciativa de calidad o interoperabilidad.
    • Data lineage en flujos de alto riesgo: trazabilidad documentada de los datos que alimentan decisiones clínicas automatizadas o semiautomatizadas —alertas de medicación, scores de riesgo, derivaciones— para que cualquier error sea rastreable hasta su origen.
    • Marco de clasificación de datos sensibles: una taxonomía que diferencie datos de salud por nivel de sensibilidad y defina controles de acceso diferenciados, alineada con los requisitos de la LGPD, Ley 25.326 o LFPDPPP según la jurisdicción operativa de la organización.

    El modelo Non-Invasive Data Governance de Bob Seiner ofrece un punto de entrada pragmático para hospitales que no quieren crear una burocracia paralela: en lugar de nombrar nuevos roles, formaliza responsabilidades que los profesionales de salud ya ejercen informalmente, lo que reduce la resistencia al cambio en culturas clínicas muy estructuradas.

    Para profundizar en los requisitos regulatorios aplicables, el texto consolidado de la LGPD está disponible en el portal de la ANPD (gov.br/anpd), y las orientaciones de la AAIP sobre datos sensibles en salud pueden consultarse en argentina.gob.ar/aaip. Ambas son lectura obligatoria para cualquier equipo que diseñe o actualice su programa de gobernanza en la región.
  • Gobernanza de datos e IA: la ventaja competitiva que los CDO no pueden ignorar

    Gobernanza de datos e IA: la ventaja competitiva que los CDO no pueden ignorar

    Las organizaciones que tratan la gobernanza de datos como un requisito de cumplimiento —y no como palanca estratégica— están perdiendo terreno frente a competidores que ya usan sus datos con trazabilidad, calidad y confianza verificables. Con la inteligencia artificial como acelerador, el costo de una mala gobernanza dejó de ser abstracto: se mide en modelos sesgados, decisiones auditadas judicialmente y multas regulatorias.

    La gobernanza de datos, en términos operativos, es el conjunto de políticas, roles, procesos y controles que determinan quién puede hacer qué con qué dato, cuándo y con qué nivel de calidad garantizado. No es un proyecto de TI: es una disciplina organizacional que cruza finanzas, legal, operaciones y ahora —de manera inseparable— los sistemas de inteligencia artificial. Sin gobernanza, un modelo de IA es una caja negra alimentada con datos de origen incierto; con gobernanza, ese mismo modelo puede auditarse, explicarse y defenderse ante un regulador.

    Por qué la IA convierte la gobernanza de datos en urgencia de negocio

    Los sistemas de IA generativa y los modelos predictivos dependen de los datos que los alimentan. Si esos datos tienen problemas de calidad, linaje incompleto o clasificación errónea, el output del modelo hereda —y amplifica— esos defectos. El marco DAMA-DMBOK v2 identifica once áreas de conocimiento en la gestión de datos; las más críticas para implementaciones de IA son precisamente las que menos madurez tienen en la mayoría de las empresas de la región: calidad de datos, linaje (data lineage) y seguridad de datos con clasificación formal. El EDM Council, a través del modelo CDMC (Cloud Data Management Capabilities), añade una capa adicional: la trazabilidad del dato en entornos cloud, que es donde la mayoría de los modelos de IA se entrenan y despliegan hoy.

    El data lineage —la capacidad de rastrear un dato desde su origen hasta su uso final, incluyendo cada transformación intermedia— es el componente que los reguladores de IA están comenzando a exigir explícitamente. El AI Act de la Unión Europea, vigente desde agosto de 2024, obliga a los proveedores de sistemas de IA de alto riesgo a documentar la procedencia y características de los datasets de entrenamiento. Esa exigencia no es opcional para empresas latinoamericanas que exporten servicios de IA a Europa o que operen filiales allí.

    Transparencia algorítmica y los marcos regulatorios en Brasil, México y Argentina

    En América Latina, la presión regulatoria sobre la IA todavía no alcanza la especificidad del AI Act europeo, pero los marcos de protección de datos ya imponen obligaciones indirectas que requieren gobernanza sólida. La Lei Geral de Proteção de Dados (LGPD) de Brasil, en su artículo 20, establece el derecho del titular a solicitar revisión de decisiones tomadas exclusivamente por medios automatizados. Ejercer ese derecho —y responderlo— exige que la organización tenga linaje documentado y pueda reconstruir la lógica del modelo. Sin gobernanza de datos, ese artículo es inejercitable en la práctica. En México, la LFPDPPP y los Lineamientos del INAI sobre tratamientos especiales apuntan en la misma dirección. En Argentina, la Agencia de Acceso a la Información Pública (AAIP) publicó en 2023 recomendaciones sobre el uso de IA en el sector público que enfatizan la necesidad de auditoría de datos de entrada.

    El dato que sintetiza el problema regional: según el informe State of Data Management de DAMA International (edición 2023), menos del 30% de las organizaciones encuestadas en mercados emergentes tienen un programa formal de calidad de datos con métricas publicadas internamente. Es decir, la mayoría de las empresas que hoy despliegan IA en LATAM lo hacen sin saber, con precisión documentada, qué tan confiables son los datos que alimentan sus modelos.

    Cuándo aplica la gobernanza de datos como ventaja competitiva — y cuándo no

    La gobernanza de datos genera ventaja competitiva verificable en escenarios concretos: sectores regulados con auditorías externas (banca, salud, seguros), organizaciones que monetizan datos como producto o insumo para terceros, y empresas que despliegan IA en decisiones que afectan a personas (crédito, contratación, scoring de riesgo). En esos contextos, la capacidad de demostrar la calidad, el origen y el tratamiento ético de los datos es diferencial. Donde la gobernanza no es ventaja competitiva inmediata —aunque sí sigue siendo necesaria— es en operaciones internas sin regulación sectorial y sin modelos de IA en producción: allí el foco inicial debería ser construir el inventario de datos (data catalog) antes de crear estructuras de gobierno complejas. Bob Seiner, referente del enfoque Non-Invasive Data Governance, subraya que los programas que empiezan por la burocracia antes que por el inventario suelen morir en el comité de aprobación.

    Tres capacidades concretas para construir gobernanza que soporte IA

    Un programa de gobernanza de datos orientado a soportar sistemas de IA debe priorizar, en este orden:

    • Clasificación formal de datos: definir qué datos son sensibles, críticos o regulados, y asignar un data steward responsable por cada dominio. Sin clasificación, no hay control de acceso diferenciado ni linaje aplicable.
    • Linaje end-to-end en los pipelines que alimentan modelos: documentar las transformaciones, joins y filtros que aplican sobre los datos antes de que lleguen al entrenamiento o a la inferencia. Herramientas como Apache Atlas, OpenMetadata o las capacidades nativas de plataformas cloud (AWS Glue DataBrew, Azure Purview) permiten automatizar buena parte de esta captura.
    • Métricas de calidad de datos publicadas y revisadas en ciclos definidos: dimensiones mínimas según DAMA-DMBOK: completitud, exactitud, consistencia y oportunidad. Sin métricas, la “calidad de datos” es una aspiración, no un estado gestionable.

    Para los CDO que operan en la región, el punto de entrada más realista en 2025 no es implementar CDMC completo —son 14 capacidades con más de 500 sub-controles— sino mapear cuáles de esas capacidades ya tienen equivalentes funcionales en la organización. Los bancos argentinos que reportan al BCRA bajo Comunicación A 7724 (gestión de riesgos tecnológicos) ya operan con controles de calidad y trazabilidad que cubren parcialmente las capabilities 6 y 8 del CDMC, aunque sin la certificación formal. El ejercicio de mapear eso toma menos tiempo del que parece y produce el argumento de negocio para financiar los gaps.

    Para profundizar en los requisitos de documentación de datasets bajo el AI Act europeo, el texto oficial está disponible en el Diario Oficial de la UE (Reglamento 2024/1689); para el contexto LATAM, las recomendaciones de la AAIP sobre IA en el sector público ofrecen el punto de partida más concreto disponible en la región a la fecha.

  • Gobernanza de datos en salud: por qué el dato clínico exige reglas distintas

    Gobernanza de datos en salud: por qué el dato clínico exige reglas distintas

    El dato clínico es el activo más sensible que gestiona una organización de salud: identifica, predice y, si se pierde el control, discrimina. Expertos del sector coinciden en que sin una gobernanza de datos robusta no hay atención centrada en el paciente, sino solo tecnología costosa sin dirección.

    Hablar de gobernanza de datos en salud no es hablar de burocracia interna. Es hablar de quién tiene autoridad sobre un expediente clínico, cómo se classifica un diagnóstico antes de que llegue a un sistema de análisis, y qué ocurre con ese dato cuando el paciente cruza de un prestador a otro. La definición operativa que maneja la industria, alineada con el DAMA-DMBOK, es clara: gobernanza de datos clínicos es el conjunto de políticas, roles y procesos que determinan quién puede usar un dato, para qué y con qué controles. Sin esa estructura, los proyectos de IA clínica, interoperabilidad y medicina personalizada colapsan antes de llegar a producción.

    El dato clínico tiene propiedades que complican su gobierno

    A diferencia del dato transaccional de un e-commerce, el dato clínico es longitudinal —acompaña al paciente décadas—, multifuente —laboratorio, imagen, farmacia, wearable— y jurídicamente sensible desde el momento de su creación. Esto impone exigencias específicas sobre el data lineage: no alcanza con saber dónde vive el dato, hay que poder reconstruir cada transformación que sufrió desde la consulta médica hasta el modelo predictivo. En sistemas hospitalarios que operan con múltiples EHR (electronic health records) y proveedores de nube, esa trazabilidad suele romperse en la primera integración. El rol del data steward clínico —distinto al steward financiero— debe incluir competencias en terminología médica estandarizada (HL7 FHIR, SNOMED CT, ICD-10) además de las capacidades habituales de governance.

    Cuándo aplica / cuándo NO una arquitectura de gobernanza estándar en salud

    Una arquitectura de gobernanza corporativa estándar aplica en salud cuando el objetivo es gestionar datos administrativos: facturación, RRHH, proveedores. No aplica —o aplica con modificaciones profundas— cuando el dato es parte del acto médico. En ese caso, los frameworks deben incorporar dimensiones de consentimiento informado, finalidad de tratamiento y minimización de datos que en otros sectores son opcionales. El EDM Council (CDMC) tiene controles específicos para datos regulados que pueden adaptarse, pero ningún marco genérico reemplaza la política de datos clínicos diseñada para el contexto sanitario específico de cada país. Un hospital que aplica DCAM capability 8 (data risk and compliance) sin adaptarlo a la normativa de salud local opera con un control de papel.

    En América Latina, la regulación sectorial presiona antes que los marcos voluntarios

    En Brasil, la Lei Geral de Proteção de Dados (LGPD, Lei 13.709/2018) clasifica los datos de salud como datos sensibles en su artículo 11, lo que impone requisitos de consentimiento específico y restringe el uso secundario —incluyendo el entrenamiento de modelos de IA— sin base legal explícita. La Autoridade Nacional de Proteção de Dados (ANPD) ha señalado el sector salud como área de atención prioritaria. En Argentina, la Ley 25.326 de Protección de Datos Personales también categoriza los datos de salud como sensibles, y las clínicas y hospitales que operan bases de datos están obligados a inscribirse ante la AAIP. En México, la LFPDPPP y su reglamento aplican a los prestadores privados, mientras que el sector público enfrenta un régimen mixto que genera fricciones operativas cuando se intenta compartir datos entre IMSS, ISSSTE y prestadores privados en proyectos de interoperabilidad. En Colombia, la Ley 1581/2012 sigue la misma lógica de datos sensibles con requisitos de autorización expresa. Ninguno de estos marcos jurídicos resuelve por sí solo el problema operativo: la gobernanza de datos es la capa que traduce la obligación legal en control técnico.

    Tres fricciones que aparecen siempre en proyectos de datos clínicos

    • Ownership difuso: el expediente clínico tiene múltiples custodios (médico, institución, paciente) y la política de datos raramente define quién tiene autoridad de decisión sobre cambios en el dato maestro del paciente.
    • Calidad en origen: los datos que ingresan al sistema de análisis provienen de digitación manual, formularios no estandarizados y sistemas legados con codificaciones propias. Sin data quality rules en el punto de captura, el modelo downstream hereda el error.
    • Consentimiento no granular: el formulario de consentimiento del paciente raramente distingue entre uso para atención directa, investigación anónima, entrenamiento de IA o compartición con aseguradoras. Esa falta de granularidad expone a la institución ante la autoridad de control cuando llega una solicitud de ejercicio de derechos.

    Resolver estas tres fricciones no es un proyecto de tecnología: es un proyecto de gobernanza con entregables concretos —política de ownership, diccionario de datos clínicos, registro de consentimientos con versionado— antes de que entre en escena cualquier plataforma.

    Para profundizar en los requisitos de tratamiento de datos sensibles en salud, el texto completo de la LGPD (artículo 11) y la Resolución CD/ANPD Nº 15/2024 sobre seguridad de la información son punto de partida obligado para cualquier equipo que opere en Brasil o aspire a interoperar con prestadores brasileños.

  • Reconocimiento facial en tiempo real llega al metro de Londres

    Reconocimiento facial en tiempo real llega al metro de Londres

    La policía ferroviaria británica comenzó a desplegar reconocimiento facial en vivo en el metro de Londres, con la estación Victoria como primer punto de implementación. La medida activa alertas entre organizaciones de privacidad, que advierten que la tecnología está dejando de ser excepcional para volverse rutinaria en el espacio público.

    El sistema, operado por la British Transport Police (BTP), permite identificar en tiempo real a personas que circulan por las instalaciones del Underground comparando sus rostros contra bases de datos de individuos buscados. No se trata de un piloto experimental: según se informó, la decisión es operativa y el despliegue progresivo comenzó en agosto de 2026. La elección de Victoria —una de las estaciones con mayor tráfico de pasajeros en toda la red— no es menor: cualquier tecnología instalada ahí alcanza escala masiva desde el primer día.

    Por qué Victoria y por qué ahora

    El argumento de las autoridades sigue el patrón estándar de seguridad pública: identificar sospechosos, prevenir delitos, proteger a los viajeros. Lo que distingue este caso es la velocidad con que el reconocimiento facial en vivo pasó de ser una tecnología cuestionada a una herramienta operativa normalizada en el Reino Unido. La policía metropolitana de Londres ya la venía usando en exteriores; extenderla al subterráneo cierra el círculo de vigilancia en los desplazamientos cotidianos de millones de personas. Grupos como Big Brother Watch llevan años documentando las tasas de error de estos sistemas —en particular su desempeño desproporcionadamente peor con personas de piel oscura— sin que eso haya frenado la expansión.

    El marco legal que habilita —y el que no regula— la biometría masiva en el Reino Unido

    En el Reino Unido post-Brexit, el régimen de protección de datos está contenido en el UK GDPR y la Data Protection Act 2018. Los datos biométricos califican como categoría especial, lo que en teoría exige una base legal reforzada para su tratamiento. Sin embargo, la excepción de prevención e investigación de delitos —artículo 10 de la DPA 2018— ha operado como puerta de entrada para estos despliegues sin que exista una ley específica sobre reconocimiento facial en espacios públicos. El Information Commissioner’s Office (ICO) ha emitido advertencias pero no ha bloqueado ningún despliegue policial. El resultado práctico es una tecnología que avanza más rápido que su propio marco normativo.

    Cuándo aplica el reconocimiento facial en vivo y cuándo no debería

    Los defensores del sistema distinguen entre reconocimiento facial retrospectivo —analizar imágenes ya capturadas tras un delito— y reconocimiento en vivo, que implica identificar personas en tiempo real sin causa previa. El primero tiene amparo jurídico más sólido; el segundo introduce vigilancia masiva de facto sobre toda persona que transite por el área monitoreada, con independencia de si es buscada o no. La diferencia es constitucional: el reconocimiento en vivo invierte la presunción de inocencia al tratar a todos los transeúntes como sujetos de escrutinio policial preventivo.

    América Latina: el mismo debate, marcos regulatorios más débiles

    Lo que ocurre en el Underground de Londres es un espejo adelantado de tensiones que ya se viven en la región. En Buenos Aires, el sistema de reconocimiento facial en el espacio público fue suspendido en 2022 por orden judicial tras comprobarse errores de identificación y uso irregular de la base de datos; la causa involucró a la Agencia de Acceso a la Información Pública (AAIP). En Brasil, la Lei Geral de Proteção de Dados (LGPD) clasifica los datos biométricos como datos sensibles bajo el artículo 11, pero no existe aún una prohibición expresa del reconocimiento facial en vivo por parte de autoridades de seguridad. En México, la LFPDPPP regula el tratamiento de datos biométricos en el sector privado con mayor precisión que en el sector público, donde los marcos son más difusos. Colombia avanza en una reforma integral a su Ley 1581 de 2012, pero el uso policial de biometría no está en el centro del debate legislativo actual. En ningún país de la región existe hoy una norma que fije con claridad los requisitos de proporcionalidad, supervisión judicial previa y auditoría de sesgos para el reconocimiento facial en vivo en espacios públicos.

    La pendiente normativa: de la excepción al estándar

    La advertencia de los grupos de privacidad británicos apunta a un riesgo sistémico que trasciende la geografía: cuando una tecnología se normaliza operativamente antes de que exista regulación específica, el costo político de prohibirla o revertirla crece con cada despliegue adicional. El Reglamento de Inteligencia Artificial de la Unión Europea (AI Act), que entró en vigor en agosto de 2024, prohíbe en su artículo 5 el uso de sistemas de identificación biométrica remota en tiempo real en espacios públicos para propósitos policiales, con excepciones acotadas. Ese estándar no aplica al Reino Unido ni a ningún país latinoamericano, pero constituye hoy la referencia de más alto rango disponible para legisladores que quieran establecer límites.

    El texto íntegro del AI Act, incluyendo las prohibiciones de biometría en tiempo real, está disponible en el Diario Oficial de la Unión Europea (Reglamento 2024/1689). Para el debate regional, el fallo judicial de Buenos Aires de 2022 y la resolución de la AAIP asociada siguen siendo la referencia jurisprudencial más concreta de América Latina sobre los límites del reconocimiento facial en el espacio público.

  • AI Act de la UE: qué deben revisar las empresas de LATAM antes de 2026

    AI Act de la UE: qué deben revisar las empresas de LATAM antes de 2026

    El AI Act de la Unión Europea ya no es un problema exclusivo de las empresas europeas. Las obligaciones del reglamento alcanzan a cualquier organización global que comercialice o despliegue sistemas de inteligencia artificial en territorio de la UE, y eso incluye a firmas latinoamericanas con operaciones, clientes o socios en Europa. Con los primeros plazos de cumplimiento ya vigentes y los correspondientes a sistemas de alto riesgo aproximándose, revisar la estrategia de compliance dejó de ser optativo.

    El Reglamento (UE) 2024/1689 —conocido como AI Act— entró en vigor el 1 de agosto de 2024. Su aplicación es escalonada: las prohibiciones absolutas sobre prácticas de IA inaceptables (manipulación subliminal, sistemas de puntuación social, reconocimiento de emociones en ciertos contextos) comenzaron a regir desde febrero de 2025. Las obligaciones para sistemas de IA de propósito general (GPAI), incluyendo los modelos de lenguaje de gran escala, aplican desde agosto de 2025. Los requisitos para sistemas de alto riesgo —los de mayor complejidad técnica y documental— vencen en agosto de 2026. El calendario no admite demoras.

    Qué define al AI Act como norma de alcance extraterritorial

    El artículo 2 del AI Act establece su ámbito de aplicación con claridad: alcanza a proveedores que comercializan o ponen en servicio sistemas de IA en la UE, independientemente de dónde estén establecidos. También alcanza a los “deployers” —empresas que utilizan sistemas de IA en sus operaciones— cuando estos se encuentran en la UE. Esto significa que una empresa con sede en Buenos Aires, Ciudad de México o São Paulo que venda software con componentes de IA a clientes europeos, o que use plataformas de IA de proveedores globales para procesar datos de ciudadanos de la UE, queda dentro del alcance del reglamento. El modelo de extraterritorialidad es análogo al del GDPR, cuya aplicación ya genera litigios y multas a empresas latinoamericanas con presencia digital en Europa.

    La clasificación de riesgo es el eje del sistema. Los sistemas de alto riesgo —listados en el Anexo III del reglamento— incluyen herramientas de reclutamiento y selección de personal, sistemas de scoring crediticio, plataformas de evaluación educativa y soluciones para infraestructura crítica. Para estas categorías, las obligaciones incluyen: documentación técnica exhaustiva, registro en una base de datos de la UE, supervisión humana, evaluación de conformidad previa al despliegue y un sistema de gestión de riesgos activo durante todo el ciclo de vida del sistema.

    El estado regulatorio de IA en Argentina, Brasil y México

    Ningún país de América Latina tiene aún una ley de IA equivalente al AI Act, pero los tres principales mercados de la región se encuentran en movimiento regulatorio activo. En Argentina, el Ministerio de Ciencia, Tecnología e Innovación publicó en 2023 una Guía para el Uso de IA Responsable en el Sector Público, de carácter no vinculante. La Agencia de Acceso a la Información Pública (AAIP) ha señalado que los sistemas de IA que traten datos personales quedan sujetos a la Ley 25.326, lo que abre la puerta a sanciones si un sistema automatizado produce decisiones sin las garantías del artículo 14 de esa norma —que reconoce el derecho a no ser objeto de decisiones basadas exclusivamente en tratamiento automatizado.

    Brasil avanza con el Proyecto de Ley 2338/2023, que sigue una arquitectura de riesgo similar al AI Act europeo y define categorías de sistemas de alto y muy alto riesgo con obligaciones diferenciadas. El proyecto está en el Senado y, según se informó, podría ser votado antes de que concluya 2025. La Autoridade Nacional de Proteção de Dados (ANPD) ya emitió en 2023 el Relatório de Atividade de Fiscalização sobre el uso de IA y datos personales, marcando la voluntad de intervenir antes de que exista una ley específica. En México, la LFPDPPP (Ley Federal de Protección de Datos Personales en Posesión de los Particulares) aplica a decisiones automatizadas que afecten a titulares, pero el país carece de un marco sectorial de IA. El INAI ha publicado documentos de posición, sin fuerza vinculante.

    Esta brecha regulatoria crea un escenario de asimetría: las empresas latinoamericanas que operan en Europa deben cumplir el AI Act sin contar con marcos locales que las guíen en cómo hacerlo. El riesgo no es solo de multa europea —que puede alcanzar hasta 35 millones de euros o el 7% de la facturación global anual para las infracciones más graves— sino de quedar excluidas de cadenas de suministro de software y servicios que ya exigen declaraciones de conformidad a sus proveedores.

    Tres brechas operativas que las empresas deben cerrar antes de agosto de 2026

    El cumplimiento del AI Act no es solo un ejercicio jurídico. Requiere capacidades técnicas y de gobernanza que muchas organizaciones latinoamericanas aún no tienen formalizadas. Las brechas más frecuentes identificadas en análisis comparativos de cumplimiento incluyen:

    • Ausencia de inventario de sistemas de IA: sin un catálogo actualizado de los modelos y herramientas en uso —incluyendo las adquiridas a terceros— es imposible clasificar el riesgo ni asignar responsabilidades. Esto es equivalente a carecer de un data catalog en gobernanza de datos.
    • Falta de documentación técnica estandarizada: el AI Act exige para sistemas de alto riesgo documentación que cubra el diseño, los datos de entrenamiento, las métricas de rendimiento y los planes de monitoreo post-despliegue. La mayoría de los equipos técnicos de la región no produce este tipo de artefactos de forma sistemática.
    • Vacío en la cadena de responsabilidad proveedor-deployer: cuando una empresa usa un modelo de IA de un proveedor global (OpenAI, Google, Microsoft, entre otros), el AI Act distribuye obligaciones entre proveedor y deployer. Sin contratos que reflejen esa distribución, el deployer asume riesgos que no anticipó.

    Qué monitorear: los próximos hitos del AI Act y sus efectos en la región

    El plazo de agosto de 2026 para sistemas de alto riesgo es el más urgente, pero no el único hito relevante. La Oficina de IA de la Comisión Europea —creada específicamente para supervisar la implementación del reglamento— publicará estándares armonizados y guías técnicas durante 2025 y 2026. Las empresas que ya operan bajo el GDPR deben prestar especial atención a la interacción entre ambos reglamentos: el AI Act no deroga el GDPR, y los sistemas de IA que traten datos personales quedan sujetos a las dos normativas en paralelo. En la práctica, esto significa que una evaluación de impacto de algoritmos puede requerir tanto una Data Protection Impact Assessment (DPIA) bajo GDPR como una evaluación de conformidad bajo AI Act.

    Para empresas latinoamericanas sin presencia física en Europa, el mecanismo de enforcement más probable en el corto plazo no será una inspección de la Comisión, sino la presión contractual de clientes y socios europeos que exijan declaraciones de conformidad como condición de negocio. Esto ya ocurre con el GDPR: muchos contratos B2B europeos incluyen desde hace años cláusulas de adecuación de privacidad. El AI Act seguirá el mismo camino.

    Nuestro análisis

    El AI Act replica el patrón del GDPR: nace en Europa, pero su efecto de arrastre normativo alcanza a cualquier empresa que quiera hacer negocios en ese mercado. Lo que todavía no ocurrió —y ocurrirá— es que los marcos regulatorios de Brasil, México y Argentina converjan hacia estándares similares, en parte por presión de organismos multilaterales y en parte porque sus propias empresas tecnológicas necesitan esa convergencia para competir globalmente. El PL 2338/2023 de Brasil, si se aprueba con su arquitectura actual, será el primer AI Act latinoamericano y funcionará como referencia regional, del mismo modo en que la LGPD impulsó actualizaciones en las leyes de privacidad de Argentina, Colombia y Chile. Las organizaciones que empiecen a documentar sus sistemas de IA y a clasificarlos por riesgo ahora no solo estarán preparando su cumplimiento europeo: estarán adelantando trabajo que sus reguladores locales les van a exigir dentro de dos o tres años.

    La pregunta no es si el AI Act aplica a tu empresa latinoamericana. La pregunta es cuántos de tus sistemas de IA en producción podrían clasificar como alto riesgo bajo sus criterios, y si tenés la documentación para demostrarlo.

  • Gobernanza de datos clínica: por qué sin ownership el expediente del paciente falla

    Gobernanza de datos clínica: por qué sin ownership el expediente del paciente falla

    En salud, un dato sin dueño claro es un dato que tarde o temprano daña a alguien. La gobernanza de datos robusta —con data stewards definidos, catálogos activos y linaje trazable desde el origen clínico— es la precondición técnica y organizacional para que el modelo de atención centrada en el paciente deje de ser un objetivo declarativo y se convierta en práctica operativa.

    El concepto de atención centrada en el paciente exige que la información clínica esté disponible, sea confiable y pueda integrarse a lo largo de todo el ciclo de cuidado: desde el primer contacto en atención primaria hasta el alta hospitalaria o el seguimiento ambulatorio. Ese flujo no es posible si los datos de salud están fragmentados en silos departamentales, si no existe un responsable formal del dato —el data steward clínico— y si los sistemas de registro no comparten un esquema semántico común. La gobernanza de datos no es, en este contexto, un problema de IT: es una decisión institucional con consecuencias clínicas directas.

    El dato clínico tiene cuatro problemas de ownership que ningún EHR resuelve solo

    Un sistema de historia clínica electrónica (EHR, por sus siglas en inglés) captura el dato, pero no garantiza su calidad ni su coherencia longitudinal. Los cuatro problemas más frecuentes en entornos hospitalarios son la duplicidad de registros de paciente (un mismo individuo con múltiples identificadores), la ausencia de definiciones maestras para términos clínicos críticos (como “diagnóstico principal” o “fecha de egreso”), la falta de linaje que permita rastrear de dónde proviene un valor y quién lo modificó, y la inexistencia de un proceso formal de certificación de calidad antes de que el dato alimente tableros de gestión o modelos predictivos. Según el marco DAMA-DMBOK, estos problemas corresponden a brechas en las áreas de conocimiento de Gestión de la Calidad del Dato y Gestión de Metadatos, y ninguna herramienta tecnológica los soluciona si no hay una estructura organizacional que asigne accountability.

    Cuándo aplica la gobernanza clínica de datos — y cuándo NO

    La gobernanza de datos en salud aplica siempre que una organización tome decisiones clínicas, operativas o regulatorias basadas en datos de pacientes: hospitales, clínicas, aseguradoras de salud, laboratorios y sistemas nacionales de información sanitaria. Aplica también cuando se alimentan modelos de inteligencia artificial con datos de historia clínica, porque un modelo entrenado sobre datos sin gobierno reproducirá los sesgos y errores del registro original. Lo que la gobernanza clínica de datos NO reemplaza es la seguridad informática (controles de acceso, cifrado, gestión de incidentes) ni la privacidad en sentido estricto (consentimiento informado, derechos de acceso y rectificación del paciente): estos son dominios complementarios que requieren sus propios programas. La confusión entre los tres dominios —gobernanza, seguridad y privacidad— es uno de los errores más comunes en los proyectos de transformación digital hospitalaria en la región.

    LATAM: tres marcos regulatorios que exigen capacidades de gobernanza sin nombrarlas así

    En América Latina, varios marcos regulatorios del sector salud implican requisitos de facto de gobernanza de datos, aunque no los llamen por ese nombre. En Brasil, la Lei Geral de Proteção de Dados (LGPD, Lei nº 13.709/2018) clasifica los datos de salud como datos sensibles y exige que el operador demuestre exactitud y actualización del dato —lo que requiere procesos de calidad y linaje—. En Argentina, la Ley 25.326 de Protección de Datos Personales establece el principio de exactitud de los datos (art. 4°), que en un hospital se traduce en la necesidad de un proceso de validación y corrección del registro clínico. En México, la LFPDPPP y las Normas Oficiales Mexicanas del sector salud —en particular la NOM-004-SSA3-2012 sobre el expediente clínico— establecen estándares de integridad y conservación que son, en esencia, requisitos de governance sin el vocabulario técnico correspondiente. Las instituciones que aún tratan estos marcos como obligaciones de IT y no como programas de gobierno del dato enfrentan el doble riesgo del incumplimiento regulatorio y de la degradación silenciosa de la calidad de su información clínica.

    Tres capacidades mínimas para un CDO de salud que opera en la región

    Cualquier programa de gobernanza de datos clínicos funcional en LATAM necesita al menos tres capacidades instaladas. Primero, un Master Data Management (MDM) de paciente: un identificador único, validado y mantenido, que permita vincular registros a lo largo del tiempo y entre sistemas. Segundo, un catálogo de datos con definiciones acordadas entre las áreas clínicas, financieras y de IT, donde cada elemento crítico —diagnóstico, medicamento, evento adverso— tenga un steward asignado con nombre y apellido. Tercero, un proceso de medición periódica de calidad del dato con indicadores formales (completitud, exactitud, consistencia) publicados internamente y vinculados a decisiones de mejora. El EDM Council (CDMC) ofrece un marco de certificación que varios sistemas de salud en Europa y Norteamérica ya están adoptando; en la región, la adopción es aún marginal, pero los requisitos regulatorios mencionados arriba convergen hacia las mismas capacidades.

    Los marcos regulatorios de salud en Brasil, Argentina y México ya exigen —con distinto vocabulario— lo mismo que un programa de gobernanza de datos clínica: exactitud, trazabilidad y accountability del dato del paciente. La brecha no es de regulación; es de implementación.

  • Juez federal regula el manejo de datos robados a Change Healthcare en litigio

    Juez federal regula el manejo de datos robados a Change Healthcare en litigio

    Un juez federal de Minnesota emitió una orden judicial que establece reglas estrictas sobre cómo los datos robados durante el ciberataque a Change Healthcare en 2024 pueden ser utilizados en el marco del litigio colectivo en curso contra UnitedHealth Group. La magistrada Dulce J. Foster aprobó el plan el 7 de agosto de 2026, según informó Becker’s.

    La orden aplica a la demanda consolidada contra UnitedHealth Group y varias empresas vinculadas, y regula el acceso, almacenamiento y circulación de la información exfiltrada durante uno de los ciberataques más graves registrados contra el sector salud en Estados Unidos. El ataque de 2024 comprometió datos de salud de decenas de millones de personas, según se informó en su momento, e interrumpió operaciones de facturación médica en todo el país.

    Orden de protección sobre datos exfiltrados: qué establece

    La medida judicial define condiciones específicas bajo las cuales abogados, peritos y partes del proceso pueden acceder al material robado que ahora forma parte del expediente. Este tipo de orden —denominada “protective order” en el sistema estadounidense— es un mecanismo procesal que busca evitar que datos sensibles incorporados como evidencia sean utilizados fuera del ámbito del juicio o sufran una exposición adicional. El hecho de que se haya formalizado un protocolo diferenciado para este material refleja la sensibilidad excepcional de los registros involucrados, que incluyen información de salud protegida bajo HIPAA.

    El expediente colectivo reúne múltiples demandas contra UnitedHealth Group por su presunta responsabilidad en el incidente, incluyendo alegaciones sobre controles de seguridad insuficientes y demoras en la notificación a los afectados. La aprobación de reglas específicas de manejo sugiere que el volumen y la naturaleza de los datos exfiltrados representan un desafío procesal sin precedentes para los tribunales federales.

    Datos confirmados y qué falta verificar

    • Fecha de aprobación de la orden: 7 de agosto de 2026.
    • Autoridad firmante: magistrada Dulce J. Foster, Distrito Federal de Minnesota.
    • Demandada principal: UnitedHealth Group y otras empresas del grupo.
    • Origen de los datos: ciberataque a Change Healthcare, ocurrido en 2024.
    • Alcance del ataque: datos de decenas de millones de personas, según se informó.

    Lo que aún no está confirmado públicamente incluye el detalle exacto de las restricciones impuestas por la orden, qué categorías específicas de datos quedan bajo el protocolo diferenciado y si la medida contempla algún mecanismo de supervisión independiente sobre el cumplimiento de las partes. Tampoco se ha informado si la orden establece plazos de destrucción o devolución del material una vez concluido el proceso.

    Para los equipos jurídicos y de cumplimiento en América Latina, el caso tiene relevancia directa. Brasil, bajo la LGPD (Lei Geral de Proteção de Dados), exige notificación a la ANPD ante incidentes con “risco ou dano relevante” a los titulares; Argentina, bajo la Ley 25.326 y las disposiciones de la AAIP, contempla obligaciones similares. La pregunta que este litigio deja abierta —si las medidas de seguridad previas eran razonables— es exactamente el estándar que los reguladores latinoamericanos aplican al evaluar responsabilidad del responsable del tratamiento. Un fallo adverso contra UnitedHealth podría convertirse en referencia comparada para futuros casos en la región.

    El próximo hito procesal a seguir es la definición del calendario de descubrimiento probatorio, que determinará en qué condiciones los datos robados serán efectivamente presentados como evidencia ante el tribunal.

  • IA en banca: por qué datos, privacidad y gobernanza frenan la transformación

    IA en banca: por qué datos, privacidad y gobernanza frenan la transformación

    Los CEOs del sector financiero reconocen el potencial transformador de la inteligencia artificial en la banca, pero señalan que la gobernanza de datos, la privacidad y la calidad de la información siguen siendo los obstáculos más difíciles de resolver. Sin datos confiables y marcos sólidos de gobierno, la IA en banca no escala: automatiza el caos.

    La promesa de la IA en servicios financieros —desde la detección de fraude hasta la personalización crediticia y la atención automatizada al cliente— lleva años circulando en las salas de directorio. Lo que está cambiando es el diagnóstico de los propios líderes sobre por qué esa promesa no se materializa a la velocidad esperada. Según se informó en declaraciones de CEOs del sector bancario, los tres cuellos de botella recurrentes son la calidad de los datos internos, las exigencias de privacidad y la ausencia de marcos de gobernanza que conecten ambos planos.

    El dato sucio como límite estructural de la IA bancaria

    Un modelo de IA entrena sobre los datos que recibe. Si esos datos tienen inconsistencias de origen, duplicaciones entre sistemas core y periféricos, o metadatos sin propietario definido, el modelo hereda esos problemas y los amplifica. En la industria financiera, donde coexisten sistemas legacy de los años 80 con plataformas cloud modernas, la fragmentación del dato no es una excepción: es la norma. El DAMA-DMBOK identifica la calidad del dato como uno de las diez áreas de conocimiento centrales en gobernanza, y en banca esa dimensión se vuelve crítica antes de cualquier proyecto de IA: si no hay data stewards definidos por dominio (clientes, productos, transacciones, riesgo), nadie puede certificar qué dato alimenta qué modelo.

    El Marco de Capacidades de Gestión de Datos del EDM Council (DCAM) establece que la capacidad 8 —gestión de calidad del dato— es prerequisito para habilitar analítica avanzada. La mayoría de los bancos medianos de América Latina operan por debajo de ese umbral sin saberlo, porque nunca realizaron una evaluación formal de madurez. Implementar IA sobre esa base equivale a construir sobre arena.

    Privacidad: la regulación que no es opcional en ninguna jurisdicción bancaria de la región

    Los bancos operan con datos personales sensibles por definición: ingresos, comportamiento de gasto, historial crediticio, identidad biométrica. En América Latina, ese universo de datos está cubierto —con distintos niveles de madurez regulatoria— por la Ley General de Protección de Datos de Brasil (LGPD), la Ley 25.326 de Argentina y su autoridad de aplicación AAIP, la Ley Federal de Protección de Datos Personales en Posesión de los Particulares de México (LFPDPPP), y la Ley 1581 de Colombia, entre otras. Cualquier sistema de IA que procese esos datos para fines distintos a los originalmente declarados al titular puede configurar una infracción, incluso si el resultado es técnicamente correcto.

    El riesgo específico en IA bancaria es el uso de datos de clientes para entrenar modelos sin base legal suficiente o sin mecanismos de exclusión disponibles para el titular. Brasil, a través de la ANPD, ya ha publicado notas técnicas sobre el uso legítimo de datos personales en sistemas automatizados. Argentina avanza en la modernización de la Ley 25.326, con un proyecto que incorpora disposiciones específicas sobre decisiones automatizadas con impacto en personas. Las instituciones que no documentan hoy qué datos alimentan qué modelos enfrentarán mañana solicitudes de acceso (DSAR) que no podrán responder.

    Gobernanza de IA: cuándo aplica y cuándo la banca no puede eludirla

    La gobernanza de IA en el sector financiero aplica en cualquier caso donde un sistema automatizado tome o asista decisiones con impacto directo sobre un cliente: aprobación o rechazo de crédito, clasificación de riesgo, detección de fraude con bloqueo de cuenta, o asignación diferenciada de productos. En todos esos escenarios, los marcos regulatorios emergentes —incluida la orientación del Comité de Basilea sobre riesgo operacional y el AI Act de la Unión Europea, que impacta a bancos con operaciones en Europa— exigen explicabilidad, supervisión humana y registros de auditoría. Un banco que no puede explicar por qué un modelo rechazó un crédito no cumple con la mayoría de las regulaciones de protección al consumidor financiero vigentes en la región.

    Lo que no aplica es la confusión entre gobernanza de datos y gobernanza de IA. Son capas distintas: la primera regula el activo (el dato); la segunda, el sistema que lo procesa. Ambas son necesarias. Un banco puede tener datos bien gobernados y aun así desplegar modelos sin accountability. El NIST AI Risk Management Framework (AI RMF) ofrece una estructura práctica para mapear riesgos por tipo de sistema y contexto de uso, adaptable al entorno regulatorio latinoamericano.

    Lo que los bancos de LATAM deben resolver antes de escalar

    En la región, la adopción de IA en banca avanza a distintas velocidades. Los bancos digitales nacidos post-2015 —Nubank en Brasil, Uala en Argentina, Mercado Pago en toda la región— parten de arquitecturas de datos modernas que facilitan la trazabilidad. Los bancos tradicionales, en cambio, enfrentan el costo y la complejidad de modernizar el dato antes de poder usarlo en producción con IA. El Banco Central de Brasil, mediante resoluciones sobre open finance, ya impone estándares de calidad e interoperabilidad que funcionan como palanca de modernización de datos: los bancos que reportan al BCB bajo esos esquemas están, en la práctica, construyendo capacidades de data lineage —trazabilidad de origen y transformación del dato— que son el primer requisito de cualquier IA auditable.

    En México, la Comisión Nacional Bancaria y de Valores (CNBV) ha incorporado criterios de gestión de riesgos tecnológicos que incluyen sistemas algorítmicos, aunque sin un marco específico de IA. En Argentina, el BCRA requiere planes de continuidad y gestión de modelos bajo la Comunicación A 7724, lo que obliga a documentar el ciclo de vida de los modelos aunque no se llame explícitamente gobernanza de IA. Esas regulaciones sectoriales existentes son el punto de entrada real para estructurar la gobernanza, no un obstáculo adicional.

    Para profundizar en los estándares aplicables, el NIST AI RMF está disponible en ai.nist.gov y el marco DCAM del EDM Council en edmcouncil.org; ambos ofrecen herramientas de autoevaluación adaptables al contexto financiero latinoamericano.

  • CRASA debatió gobernanza de datos e IA en su comité de política regional

    CRASA debatió gobernanza de datos e IA en su comité de política regional

    El Comité Legal y de Política de CRASA —la asociación de reguladores de telecomunicaciones del sur y este de África— abrió formalmente una sesión de trabajo dedicada a inteligencia artificial, gobernanza de datos y regulación regional de las TIC. El encuentro señala un punto de inflexión: los reguladores de una de las regiones con mayor crecimiento de infraestructura digital del mundo reconocen que sus marcos normativos no están diseñados para los ecosistemas de datos actuales. Para América Latina, que enfrenta el mismo desfasaje entre velocidad tecnológica y capacidad regulatoria, el movimiento africano ofrece una referencia metodológica concreta.

    CRASA y los 16 reguladores que coordinan el sur de África

    CRASA (Communications Regulators’ Association of Southern Africa) agrupa a las autoridades regulatorias de telecomunicaciones de 16 países del sur y este del continente africano. Su Comité Legal y de Política actúa como espacio de armonización normativa: cuando ese comité abre una sesión específica sobre IA y gobernanza de datos, no está explorando tendencias académicas sino evaluando si los instrumentos regulatorios existentes —licencias, obligaciones de reporte, regímenes de acceso a infraestructura— son suficientes para gobernar flujos de datos transfronterizos, sistemas automatizados de decisión y modelos de IA desplegados por operadores con presencia regional. Según se informó, la agenda incluyó el análisis del estado de avance de los marcos nacionales frente a los requerimientos de la economía digital.

    Por qué un comité de telcos discute gobernanza de datos en 2025

    La convergencia entre regulación de telecomunicaciones y gobernanza de datos no es una anomalía: es la consecuencia lógica de que los operadores de redes son, simultáneamente, los mayores recolectores de datos de comportamiento, geolocalización y comunicaciones de sus países. Cuando un regulador TIC fija condiciones para una licencia de operación, está —aunque no lo nombre explícitamente— estableciendo quién tiene acceso a qué datos, bajo qué condiciones y con qué obligaciones de retención. El Comité de CRASA está haciendo explícito algo que en muchas jurisdicciones permanece implícito: la regulación de infraestructura digital es, en el fondo, una forma de gobernanza de datos.

    Desde la perspectiva del DAMA-DMBOK, esto equivale a reconocer que el “data ownership” no puede resolverse solo dentro de las organizaciones —requiere un marco externo que defina derechos, responsabilidades y mecanismos de control a nivel sectorial y regional. Los reguladores africanos están intentando construir ese marco colectivamente, algo que en América Latina todavía se hace de manera fragmentada y fundamentalmente reactiva.

    Brasil, México y Colombia: tres velocidades en el mismo problema

    América Latina no parte de cero. Brasil cuenta con la Lei Geral de Proteção de Dados (LGPD, Lei nº 13.709/2018) y con la ANPD como autoridad de aplicación, que en 2024 emitió regulaciones sobre agentes de tratamiento y bases legales. Sin embargo, la ANPD no tiene mandato explícito sobre gobernanza corporativa de datos más allá de lo que impone la LGPD: no puede exigir que una empresa implemente un catálogo de datos, defina data stewards o mantenga linaje documentado, a menos que esa ausencia derive en una violación de los principios de seguridad o minimización de la ley.

    México opera bajo la Ley Federal de Protección de Datos Personales en Posesión de los Particulares (LFPDPPP, 2010) y el INAI como regulador, con un marco centrado en derechos ARCO que tiene escasa incidencia en cómo las empresas organizan internamente sus arquitecturas de datos. Colombia, por su parte, cuenta con la Ley 1581 de 2012 y la Superintendencia de Industria y Comercio (SIC), que ha avanzado en orientaciones sobre transferencias internacionales, pero aún no emitió guías técnicas sobre gestión del ciclo de vida del dato equivalentes a las que se esperan de un marco CDMC. El resultado es que las tres jurisdicciones más grandes de la región tienen marcos de privacidad razonablemente maduros pero marcos de gobernanza de datos corporativa virtualmente inexistentes desde el ángulo regulatorio.

    Lo que los CDOs de la región pueden tomar del modelo CRASA

    El valor del enfoque de CRASA no está en sus resoluciones —que todavía no se conocen públicamente— sino en su método: un comité sectorial que evalúa sistemáticamente si los instrumentos regulatorios existentes son adecuados para los activos de datos que los operadores manejan. Ese ejercicio de mapeo —”¿tenemos cobertura normativa para este tipo de dato, este tipo de sistema, este tipo de flujo transfronterizo?”— es exactamente lo que los marcos de gobernanza maduros como DCAM (Data Capability Assessment Model del EDM Council) proponen hacer a nivel organizacional.

    Un CDO en Argentina, Brasil o Colombia puede tomar ese modelo y aplicarlo internamente: mapear las capacidades de gobernanza existentes contra los requerimientos que la regulación sectorial ya impone —comunicaciones al BCRA bajo la Comunicación A 8073 para bancos argentinos, reportes de incidentes a la ANPD bajo el artículo 48 de la LGPD, o notificaciones a la SIC en Colombia— e identificar las brechas reales. Ese mapeo es el punto de partida para un roadmap de gobernanza que no sea aspiracional sino jurisdiccionalmente anclado. La semana que viene es una buena fecha para abrir ese inventario: quién es el data steward de cada dominio regulado, qué linaje está documentado, qué no.

    Qué monitorear: la agenda regulatoria TIC en LATAM durante el segundo semestre de 2025

    El movimiento de CRASA coincide con una ventana activa en la región. En Chile, la Ley 21.719 de Protección de Datos Personales —promulgada en diciembre de 2024 y con entrada en vigor escalonada— incluye obligaciones de seguridad y gobernanza que van más allá de los marcos anteriores. En Perú, la Ley 29733 está bajo revisión legislativa. En Brasil, la ANPD tiene en su agenda la regulación de decisiones automatizadas. Ninguno de estos procesos cuenta aún con un comité equivalente al de CRASA —un espacio de armonización técnica entre reguladores— lo que hace que el intercambio de experiencias entre países siga dependiendo de foros informales o de la intermediación de organismos como la CEPAL o la OEA.

    Nuestro análisis

    La sesión de CRASA importa menos por lo que resuelva que por lo que institucionaliza: la gobernanza de datos como agenda regulatoria sectorial, no solo como obligación de privacidad individual. Esa distinción es crucial. Mientras los marcos latinoamericanos siguen atando gobernanza de datos a derechos de titulares —un enfoque necesario pero insuficiente—, otros bloques regionales están construyendo la capa de gobernanza corporativa e interoperabilidad que permite que esos derechos sean ejercibles en la práctica. Una empresa que no sabe qué datos tiene, dónde están y quién es responsible de cada dominio no puede responder un DSAR en 30 días ni notificar una brecha en 72 horas. El orden lógico es: gobernanza primero, cumplimiento como resultado. Eso es lo que CRASA, al menos en el papel, está intentando formalizar.

    La pregunta concreta para los equipos de datos en la región: ¿puede su organización responder hoy, sin buscar en carpetas, quién es el data steward de cada sistema que toca datos regulados? Si la respuesta es no, ese es el primer gap que documentar.

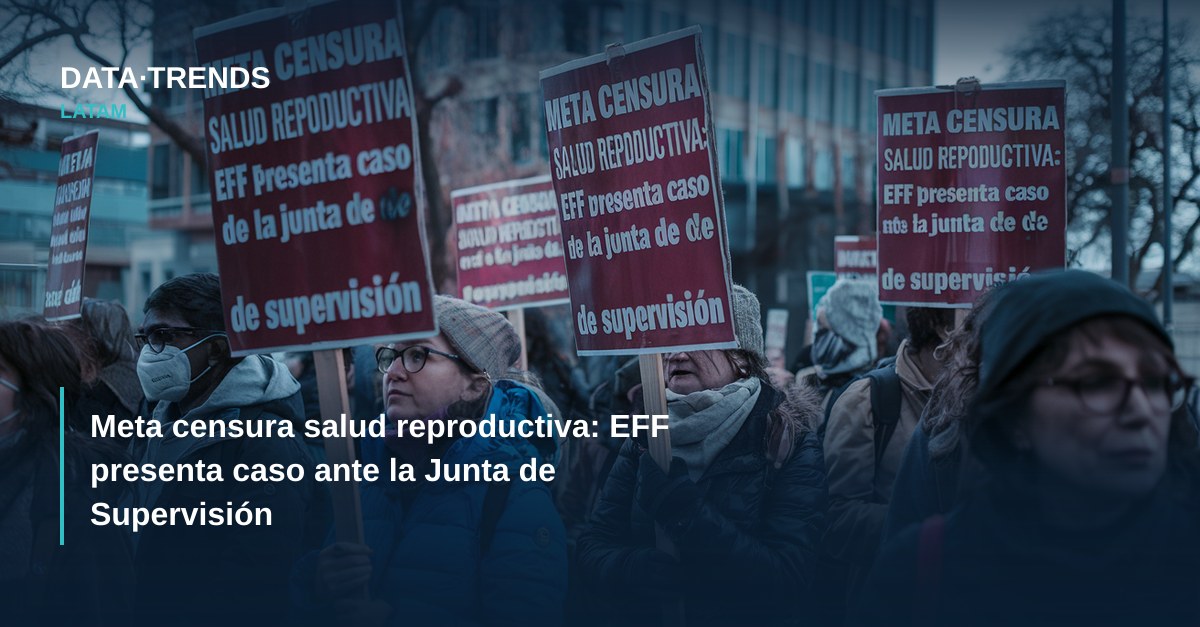
  • Meta censura salud reproductiva: EFF presenta caso ante la Junta de Supervisión

    Meta censura salud reproductiva: EFF presenta caso ante la Junta de Supervisión

    La Electronic Frontier Foundation presentó un comentario público ante la Junta de Supervisión de Meta documentando un patrón sistemático: las plataformas del grupo —Instagram en particular— eliminan contenido legítimo sobre salud reproductiva al confundirlo con tráfico de medicamentos. El caso en análisis involucra una publicación de Instagram sobre medicamentos de prescripción durante el embarazo y el parto.

    El problema no es anecdótico. A través del proyecto Stop Censoring Abortion, la EFF recopiló cerca de cien testimonios de proveedores de salud, clínicas, educadores, investigadores y advocates cuyo contenido había sido eliminado o suprimido por plataformas de redes sociales. El denominador común: en casi todos los casos documentados, las publicaciones censuradas no violaban las reglas declaradas de las plataformas.

    La política de bienes restringidos de Meta y su aplicación sobre contenido médico legítimo

    Meta invoca con frecuencia su Política de Bienes y Servicios Restringidos, que prohíbe intentos de comprar, vender, intercambiar, donar o solicitar medicamentos farmacéuticos. El problema es que el sistema de moderación no distingue entre esa conducta prohibida y la discusión factual o educativa sobre esos mismos medicamentos. Según la documentación de la EFF, el contenido eliminado consistía abrumadoramente en información clínica, experiencias personales con la atención médica y datos para acceder a servicios legales, no en ofertas comerciales de fármacos.

    Los efectos concretos fueron significativos. La Miscarriage+Abortion Hotline tuvo su cuenta de Instagram restringida y publicaciones eliminadas a pesar de que su actividad se limitaba a informar sobre cómo obtener medicación de manera legal. Red River Women’s Clinic y el centro de investigación RISE de la Universidad de Emory enfrentaron situaciones similares. Se documentaron además bajas repentinas de cuentas, desranqueo de perfiles sin notificación y procesos de apelación que, según la EFF, rara vez llegaban a una resolución concreta.

    Cuándo aplica la restricción y cuándo no: el límite que los sistemas automáticos no logran trazar

    La política de Meta aplica —al menos en su formulación textual— a transacciones comerciales de medicamentos no autorizadas. No aplica, en principio, a la información médica de acceso público, a la educación sanitaria ni a los testimonios personales sobre experiencias de salud. El fallo documentado por la EFF ocurre en la capa de detección: los sistemas automáticos identifican palabras clave o patrones asociados a fármacos específicos sin evaluar el contexto de la publicación. El resultado es lo que la EFF denomina sobre-aplicación sistémica: el contenido con más probabilidad de ser eliminado es, paradójicamente, el que proviene de actores institucionales con perfiles verificables y contenido clínicamente preciso.

    Este tipo de sobre-moderación no es un error técnico menor. Cuando una clínica pierde su cuenta de Instagram sin posibilidad real de apelar, se interrumpe un canal de acceso a información que para muchas personas —especialmente en contextos de baja escolaridad o zonas rurales— puede ser el único disponible. La EFF sostiene que la Junta de Supervisión de Meta tiene ante sí la oportunidad de establecer un estándar claro: hablar sobre medicamentos no equivale a venderlos.

    El régimen de moderación de contenido y los derechos digitales en América Latina

    En América Latina, la tensión entre moderación de contenido y libertad de expresión en salud reproductiva adquiere dimensiones adicionales. Varios países de la región —entre ellos Argentina, Ecuador, Honduras y El Salvador— tienen marcos legales restrictivos sobre el aborto, lo que genera incentivos para que los sistemas de moderación sean aún más agresivos con contenido relacionado. En México, donde la Ley Federal de Protección de Datos Personales en Posesión de los Particulares (LFPDPPP) regula el tratamiento de datos de salud como categoría sensible, la eliminación arbitraria de cuentas de salud también plantea interrogantes sobre el tratamiento que las plataformas dan a la información que recopilan antes de eliminar el contenido. En Brasil, la Autoridade Nacional de Proteção de Dados (ANPD) ha comenzado a observar con mayor atención las prácticas de las plataformas sobre datos sensibles, categoría que bajo la Lei Geral de Proteção de Dados (LGPD) incluye explícitamente datos sobre salud. La sobre-moderación, en este marco, no es solo un problema de libertad de expresión: puede implicar tratamiento indebido de datos personales sensibles.

    La Junta de Supervisión de Meta es un mecanismo de rendición de cuentas de alcance global. Sus decisiones se aplican a todas las plataformas del grupo en todos los países donde operan. Eso significa que un fallo que establezca criterios más precisos para distinguir información médica legítima de transacciones comerciales prohibidas tendría efecto directo sobre millones de usuarios latinoamericanos.

    El comentario completo de la EFF ante la Junta de Supervisión de Meta, así como los testimonios recopilados a través del proyecto Stop Censoring Abortion, están disponibles en eff.org/pages/stop-censoring-abortion. La decisión de la Junta sobre el caso de medicamentos durante el embarazo aún está pendiente.