Autor: Redacción

  • Primero los datos, después la IA: la apuesta de Brookfield Residential

    Primero los datos, después la IA: la apuesta de Brookfield Residential

    Brookfield Residential decidió invertir en gobernanza de datos antes de escalar cualquier iniciativa de inteligencia artificial. La lógica detrás de esa decisión es simple pero poco frecuente en el sector: sin datos confiables, los modelos de IA reproducen el caos a mayor velocidad.

    La industria inmobiliaria no suele ser la primera en aparecer en conversaciones sobre madurez de datos. Sin embargo, la desarrolladora canadiense Brookfield Residential —con operaciones en Estados Unidos y Canadá— se convirtió en un caso de referencia al anteponer la construcción de una base de gobernanza sólida a la adopción de herramientas de inteligencia artificial. La decisión, según se informó, surgió de reconocer que sus datos operativos —precios, inventarios, ciclos de construcción, perfiles de compradores— estaban fragmentados entre sistemas que no hablaban entre sí.

    Qué significa “poner la gobernanza primero” en la práctica

    En términos operativos, anteponer la gobernanza implica resolver tres problemas antes de entrenar o desplegar cualquier modelo: definir quién es el propietario del dato (data ownership), establecer definiciones compartidas entre áreas (data definitions o business glossary), y mapear el recorrido del dato desde su origen hasta su uso analítico (data lineage). Estos tres pilares son la base del marco DAMA-DMBOK, que organiza las capacidades de gestión de datos en once áreas de conocimiento. Sin ellos, una organización que alimenta un modelo de IA con datos de baja calidad no obtiene predicciones mejores: obtiene predicciones incorrectas con mayor velocidad y apariencia de precisión.

    En el caso de Brookfield Residential, según se informó, el trabajo incluyó la designación de data stewards por área de negocio —roles responsables de asegurar la calidad y el uso apropiado del dato dentro de su dominio— y la implementación de un catálogo de datos que permitiera a los equipos encontrar, entender y confiar en los activos de información disponibles. Este tipo de arquitectura de gobierno es lo que el EDM Council denomina una capability central dentro del CDMC (Cloud Data Management Capabilities), específicamente en el dominio de Data Governance and Accountability.

    Cuándo aplica este enfoque —y cuándo no

    La secuencia “gobernanza antes que IA” aplica con mayor fuerza cuando los datos están dispersos en silos operacionales heterogéneos, cuando los equipos de negocio tienen definiciones distintas para los mismos conceptos (¿qué es una “unidad vendida”? ¿en qué momento del proceso?), o cuando existe una brecha significativa entre los datos históricos disponibles y los que realmente se necesitan para entrenar un modelo útil. No aplica de la misma forma en organizaciones que ya tienen un data warehouse consolidado, pipelines de calidad implementados y ownership claro: en esos casos, la gobernanza puede avanzar en paralelo con los primeros pilotos de IA sin riesgo sistémico.

    El error más frecuente no es desplegar IA prematuramente, sino subestimar cuánto trabajo previo de gobernanza se necesita. Muchas organizaciones descubren ese déficit recién cuando el modelo falla —o peor, cuando falla silenciosamente y nadie lo detecta a tiempo.

    América Latina: el mismo desafío, menor tiempo para resolverlo

    En la región, el caso de Brookfield Residential resuena especialmente en sectores como real estate, banca y retail, donde la adopción de herramientas de IA generativa avanza más rápido que la madurez de los datos subyacentes. En Brasil, las instituciones financieras supervisadas por el Banco Central operan bajo la Resolução CMN 4.893/2021, que exige políticas de gestión de datos como parte del marco de gestión de riesgos —lo que obliga, al menos formalmente, a tener ownership y calidad de datos definidos antes de automatizar decisiones crediticias con modelos. En Argentina, la Comunicación A 8073 del BCRA establece requisitos similares para el gobierno de datos en entidades financieras, aunque la certificación formal bajo marcos como CDMC sigue siendo prácticamente inexistente en la industria local.

    En México, Colombia y Chile, las normativas sectoriales de finanzas y salud empujan en la misma dirección, pero fuera de esos sectores regulados la presión para formalizar la gobernanza antes de escalar IA es todavía baja. El riesgo real es que las organizaciones latinoamericanas lleguen tarde no al tren de la IA, sino a la infraestructura de datos que la hace funcionar.

    Lo que un CDO puede hacer esta semana con este caso

    El caso de Brookfield Residential ofrece una palanca concreta para quienes lideran datos en organizaciones que ya tienen proyectos de IA en agenda. Primero, auditar el estado de los datos que alimentarán esos modelos: ¿tienen un propietario identificado? ¿hay una definición acordada entre negocio y tecnología? ¿el lineage está documentado? Segundo, usar ese diagnóstico como argumento ante el comité ejecutivo para priorizar inversión en gobernanza —no como obstáculo a la IA, sino como condición de su éxito. Tercero, si la organización ya tiene un catálogo de datos, verificar que los datasets candidatos para IA estén efectivamente catalogados y con metadata de calidad actualizada. La secuencia de Brookfield no es conservadora: es la que minimiza el costo de retrabajo cuando el modelo ya está en producción.

    Para profundizar en los fundamentos de este enfoque, el DAMA-DMBOK (segunda edición) y el framework CDMC del EDM Council son los puntos de partida más citados por equipos de gobierno de datos a nivel global.
  • Pentágono: 2,7 millones de registros militares expuestos en brecha de meses

    Pentágono: 2,7 millones de registros militares expuestos en brecha de meses

    Una brecha de datos que se extendió durante varios meses comprometió los registros de 2,7 millones de integrantes del personal militar de Estados Unidos, según informó TechRadar el 1 de octubre de 2025. Los datos expuestos incluyen nombres completos, historiales de servicio militar y números de Seguro Social.

    El incidente involucra al Departamento de Defensa de Estados Unidos —el Pentágono— y se habría prolongado durante meses antes de ser detectado y contenido, según se informó. La escala del compromiso lo convierte en una de las filtraciones de datos de personal militar más significativas registradas públicamente. No se confirmó hasta el momento qué actor o vector técnico estuvo detrás del acceso no autorizado.

    Datos confirmados del incidente

    • 2,7 millones de registros de personal militar expuestos
    • Tipos de datos comprometidos: nombres completos, historial de servicio militar y números de Seguro Social
    • La brecha se extendió durante varios meses antes de su detección, según se informó
    • Organización afectada: Departamento de Defensa de Estados Unidos (Pentágono)

    Qué se sabe y qué falta confirmar

    Hasta la fecha de publicación de esta alerta, no se ha confirmado públicamente el vector de ataque ni la identidad del o los responsables. Tampoco se informó si los datos filtrados ya circulan en foros o mercados de acceso restringido. Se desconoce si el Departamento de Defensa inició notificaciones individuales a los afectados ni en qué plazos. La atribución del incidente —estatal, criminal u otra— permanece sin confirmar según la información disponible.

    Para las organizaciones con personal que opera en América Latina bajo contratos de defensa o cooperación con agencias del gobierno de Estados Unidos, la exposición de números de Seguro Social combinada con historiales de servicio representa un riesgo de ingeniería social e identidad que trasciende fronteras. Brasil, Colombia, Perú y México cuentan con marcos de protección de datos personales —LGPD, Ley 1581 de 2012, Ley 29733 y LFPDPPP, respectivamente— que obligan a los responsables de tratamiento a evaluar el impacto cuando datos de sus titulares resultan comprometidos por terceros, incluso en cadenas de custodia internacionales.

    El próximo hito crítico es la confirmación oficial por parte del Departamento de Defensa sobre el alcance real de la brecha y el inicio formal del proceso de notificación a los 2,7 millones de afectados.

  • Cloudflare lanza su plataforma de datos Basin: sin egress fees, datos en el borde

    Cloudflare lanza su plataforma de datos Basin: sin egress fees, datos en el borde

    Cloudflare presentó Basin, una plataforma serverless de gestión de datos que promete eliminar —o al menos reducir significativamente— los cargos por egress de datos. La propuesta apunta directamente a uno de los costos ocultos más debatidos en arquitecturas cloud modernas: el precio de mover datos entre capas y proveedores.

    Basin se posiciona como una solución de gestión de datos sin servidor construida sobre la infraestructura de red de Cloudflare. La idea central es que los datos vivan cerca del borde de la red —donde se procesan las solicitudes— en lugar de residir en regiones centralizadas de cómputo. Esto, según la compañía, permite reducir la latencia y, sobre todo, evitar los cargos por transferencia de datos salientes que los grandes proveedores de nube —AWS, Azure, Google Cloud— aplican como parte estándar de su modelo de negocio.

    Egress fees: el costo que no aparece en el presupuesto inicial

    Los cargos por egress —la tarifa que cobra un proveedor de nube cada vez que los datos salen de su infraestructura— son uno de los mecanismos de lock-in más efectivos del mercado. Una organización puede ingresar datos a AWS o Google Cloud prácticamente sin costo, pero moverlos hacia otro entorno, hacia un sistema on-premise o hacia un socio externo puede generar facturas inesperadamente elevadas. En América Latina, donde muchas organizaciones operan con infraestructura híbrida y proveedores múltiples, este costo tiene un impacto desproporcionado respecto a los presupuestos de TI disponibles.

    Cloudflare no es el primero en atacar este modelo: su propia oferta de almacenamiento R2 ya eliminó los egress fees para datos almacenados en esa capa. Basin extiende esa lógica al plano de la gestión de datos como plataforma integrada, aunque la promesa de “sin egress fees” viene acompañada de un “sort of” —es decir, con matices que dependerán del caso de uso concreto y de los límites del plan contratado.

    Qué incluye Basin y qué significa “serverless” en este contexto

    Una plataforma serverless de datos no significa que no existan servidores —significa que el cliente no los administra. La organización define su lógica de procesamiento y almacenamiento; la infraestructura escala automáticamente según demanda. Para equipos de datos sin una práctica robusta de infraestructura, esto reduce la carga operativa. Para equipos maduros, el interrogante habitual es si el nivel de control y observabilidad está a la altura de lo que ofrecen plataformas más establecidas. Según se informó, Basin integra capacidades de gestión de datos distribuidos sobre la red global de Cloudflare, aunque los detalles técnicos completos sobre soporte de motores SQL, integración con pipelines existentes y SLAs aún no estaban disponibles en el lanzamiento.

    Cuándo aplica Basin — y cuándo no

    Basin tiene sentido para organizaciones que ya operan sobre Workers, Pages u otros productos de Cloudflare, y que buscan una capa de datos cohesionada dentro del mismo ecosistema. También es relevante para casos de uso con distribución geográfica intensiva —CDN-first, APIs con usuarios en múltiples países, aplicaciones edge-native— donde el egress entre regiones es un factor de costo real. No aplica como reemplazo directo de un data warehouse analítico pesado (Snowflake, BigQuery, Redshift), ni para organizaciones con necesidades de procesamiento masivo OLAP o con modelos de gobernanza que requieren residencia estricta de datos en jurisdicciones específicas. En este último punto, los equipos legales y de cumplimiento en América Latina deberán verificar en qué nodos de la red de Cloudflare residirán efectivamente los datos, especialmente frente a requisitos de la LGPD brasileña (artículos 33 y 34 sobre transferencia internacional), la Ley 25.326 argentina o la Ley Estatutaria 1581 de Colombia.

    Residencia de datos y cumplimiento en América Latina

    La propuesta de Cloudflare de distribuir datos en el borde global plantea una tensión directa con los marcos regulatorios de protección de datos personales en la región. La LGPD de Brasil establece condiciones específicas para la transferencia internacional de datos personales; la Ley 25.326 de Argentina y su reglamentación exigen garantías equivalentes cuando los datos salen del país; Chile avanza con su nueva ley de protección de datos personales (Ley 21.719), que también contempla restricciones de transferencia. Para cualquier organización latinoamericana que evalúe Basin como plataforma de datos operativos —no solo estáticos— la pregunta de “¿en qué país físicamente residen mis datos?” no es opcional. Cloudflare ofrece controles de jurisdicción en algunos de sus productos, pero la verificación caso por caso es responsabilidad del responsable de tratamiento.

    Antes de migrar cargas de trabajo a Basin, un equipo de datos responsable debería mapear qué tipos de datos procesará la plataforma, identificar si incluye datos personales según la ley aplicable, y confirmar con Cloudflare qué garantías de residencia y transferencia ofrece para cada región de América Latina donde opera la organización. La referencia normativa de partida está en la documentación oficial de cada autoridad de control: ANPD (Brasil), AAIP (Argentina), SIC (Colombia) e INAI (México).

  • Gemini 4 Argon de Google y el desafío de gobernar flujos de IA de larga duración

    Gemini 4 Argon de Google y el desafío de gobernar flujos de IA de larga duración

    Los modelos de IA capaces de ejecutar flujos de trabajo autónomos durante horas o días no son un problema de ingeniería: son un problema de gobernanza de datos. El lanzamiento de Gemini 4 Argon por parte de Google fuerza a los equipos de datos a repensar qué significa “controlar” un proceso cuando el agente toma decisiones encadenadas sin intervención humana entre cada paso.

    Gemini 4 Argon fue diseñado específicamente para sostener flujos de trabajo de agentes de IA que se extienden en el tiempo —lo que la industria llama long-running agentic workflows— con capacidad para mantener contexto, ejecutar subtareas y operar sobre múltiples fuentes de datos de forma secuencial. A diferencia de una consulta puntual a un modelo de lenguaje, estos flujos pueden durar minutos, horas o incluso días, tomando decisiones intermedias sobre qué datos consultar, transformar o escribir. Ese ciclo extendido es exactamente lo que los marcos de gobernanza tradicionales no contemplaron.

    Por qué los flujos agentivos rompen los controles de data lineage existentes

    El concepto de data lineage —trazabilidad del origen, movimiento y transformación de un dato a lo largo de su ciclo de vida— asume, en la mayoría de las implementaciones actuales, que los procesos son discretos y auditables en tiempo razonable. Un pipeline ETL tiene un inicio, una transformación documentada y un destino. Un agente de IA que opera durante horas genera decisiones intermedias que no quedan registradas en ningún catálogo de datos si la arquitectura no fue diseñada para capturarlas. El resultado es un agujero negro de linaje: se sabe de dónde partió el proceso y dónde terminó, pero no qué datos intermedios influyeron en cada decisión.

    Según el marco DAMA-DMBOK, la trazabilidad es uno de los once dominios de conocimiento de gestión de datos y está directamente vinculada a la confiabilidad del dato para la toma de decisiones. Cuando un agente de IA actúa como transformador dinámico —no como un script predecible— ese dominio queda sin cobertura real a menos que se instrumente el modelo desde el diseño. El EDM Council, en su estándar CDMC (Cloud Data Management Capabilities), lista el control de acceso granular y la auditabilidad como capabilities de nivel 8, justamente las más difíciles de mantener cuando el ejecutor del proceso es un modelo generativo.

    El problema de ownership cuando el agente escribe, no solo lee

    La distinción entre lectura y escritura de datos es central para cualquier esquema de data stewardship. Los data stewards —los responsables operativos de la calidad, clasificación y uso adecuado de un conjunto de datos dentro de un dominio— pueden supervisar pipelines que consumen datos, pero la situación se complica cuando el agente también produce o modifica registros. Un flujo de Gemini 4 Argon que, por ejemplo, enriquece un CRM con datos de fuentes externas, clasifica registros y actualiza campos de manera autónoma está ejerciendo funciones que hasta ahora correspondían a un proceso controlado por un humano o un script revisado. ¿A qué steward le pertenece ese output? ¿Quién valida la calidad del dato generado?

    Bob Seiner, referente de Non-Invasive Data Governance, argumenta que la gobernanza efectiva no requiere nuevos roles sino extender la accountability de los existentes hacia los procesos que los afectan. Aplicado aquí: el steward del dominio CRM debería tener visibilidad sobre qué transformaciones realizó el agente y con qué criterio, lo que exige instrumentación explícita en la capa de orquestación del modelo.

    Cuándo aplica este desafío — y cuándo no

    Este problema de gobernanza es relevante cuando el flujo agentivo opera sobre datos regulados, clasificados como sensibles o que alimentan decisiones con impacto en personas. No aplica de la misma manera a agentes que solo consumen datos públicos o ejecutan tareas de bajo impacto sin persistencia. La diferencia práctica: si el output del agente va a un sistema de registro (ERP, CRM, data warehouse, lago de datos), la gobernanza es obligatoria; si el output es efímero y no persiste, el riesgo de linaje es menor aunque no nulo.

    En América Latina, este umbral tiene implicancias regulatorias directas. Las empresas sujetas a la Lei Geral de Proteção de Dados (LGPD) en Brasil deben ser capaces de demostrar, ante la Autoridade Nacional de Proteção de Dados (ANPD), qué tratamientos automatizados se realizan sobre datos personales y con qué base legal. Un flujo agentivo que procesa datos personales sin trazabilidad auditada pone a la organización en incumplimiento del artículo 20 de la LGPD, que reconoce el derecho a la revisión de decisiones automatizadas. En Argentina, la situación es análoga bajo la Ley 25.326 y las disposiciones de la Agencia de Acceso a la Información Pública (AAIP), aunque el marco de decisiones automatizadas está menos desarrollado normativamente que en Brasil.

    Tres controles que un CDO debe instrumentar antes de habilitar flujos agentivos en producción

    La habilitación de modelos como Gemini 4 Argon en entornos empresariales no puede quedar librada a los equipos de ingeniería sin una política de gobernanza explícita. Los controles mínimos que un Chief Data Officer debe exigir antes de poner un flujo agentivo de larga duración en producción incluyen:

    • Registro de decisiones intermedias: cada acción del agente sobre un conjunto de datos —lectura, transformación, escritura— debe quedar logueada en un sistema de auditoría externo al modelo, no solo en los logs nativos del proveedor cloud.
    • Clasificación de datos en scope: antes de lanzar el flujo, el catálogo de datos debe marcar explícitamente si los datasets involucrados contienen datos personales, datos regulados o datos de alta criticidad para el negocio. Si el catálogo no tiene esa clasificación, el flujo no debería habilitarse.
    • Steward asignado al output: cada dataset producido o modificado por el agente debe tener un data steward nombrado que valide la calidad y el uso adecuado del resultado antes de que se propague a sistemas downstream.

    Estos controles no son exclusivos de Gemini 4 Argon: aplican a cualquier framework agentivo, incluyendo los basados en modelos de Anthropic, OpenAI o soluciones open-source como LangGraph. La particularidad de Argon es que su capacidad extendida de contexto y duración eleva el riesgo de linaje a una escala que los controles actuales de la mayoría de las organizaciones latinoamericanas no están preparados para cubrir.

    Para profundizar en los marcos de referencia aplicables, el CDMC del EDM Council (edmc.net/cdmc) y el capítulo de Data Quality del DAMA-DMBOK son los puntos de partida más robustos para estructurar una política de gobernanza sobre flujos agentivos.

  • Opt Out October: alternativas reales a los gigantes tecnológicos

    Opt Out October: alternativas reales a los gigantes tecnológicos

    La Electronic Frontier Foundation lanzó la segunda edición de Opt Out October, una iniciativa que este año va más allá de ajustar configuraciones de privacidad: propone abandonar plataformas, aplicaciones y sistemas operativos de las grandes tecnológicas en favor de alternativas con menor huella de datos. El planteo llega en un momento en que legislaciones como la LGPD brasileña, la Ley 25.326 argentina y la LFPDPPP mexicana consolidan el derecho a la portabilidad y a la supresión de datos personales —derechos que solo pueden ejercerse si los usuarios saben que existen.

    Opt Out October nació en 2025 como un recordatorio mensual para revisar configuraciones dentro de las aplicaciones más usadas. En su edición 2026, la EFF amplió el alcance: el eje ya no es solo ajustar permisos, sino evaluar si ciertos servicios deberían seguir siendo parte del ecosistema digital de cada persona u organización. La iniciativa incluye una plataforma de recursos con guías para migrar a software alternativo, explorar redes sociales descentralizadas y controlar el uso de datos personales en el entrenamiento de modelos de inteligencia artificial.

    Por qué migrar es más que una decisión técnica

    Cambiar de plataforma implica ejercer derechos que la regulación reconoce pero que los usuarios raramente activan. En Brasil, el artículo 18 de la LGPD garantiza la portabilidad de datos a otro proveedor de servicio o producto. En México, el derecho de cancelación bajo la LFPDPPP permite exigir la supresión de datos que un responsable ya no necesita. En Argentina, la Ley 25.326 reconoce el derecho a la eliminación de datos inexactos o innecesarios. Migrar de un servicio no solo es posible: en muchos casos, es el único acto que materializa esos derechos, dado que las solicitudes de supresión enviadas a grandes plataformas suelen tener cumplimiento parcial o tardío.

    La EFF no enumera en su comunicado qué alternativas específicas recomienda para cada categoría de software, pero sí organiza su hub de recursos en cuatro ejes: nuevas aplicaciones no desarrolladas por gigantes tecnológicos, opciones de redes sociales fuera del ecosistema Meta-Google-X, sistemas operativos alternativos, y herramientas para limitar el uso de datos personales en el entrenamiento de inteligencia artificial generativa. Este último punto es especialmente relevante: varios proveedores incorporaron cláusulas en sus términos de servicio que autorizan el uso de contenido generado por usuarios para mejorar sus modelos, sin que el usuario promedio lo advierta.

    Cuándo aplica la migración de plataforma y cuándo no es suficiente

    Optar por software alternativo tiene sentido claro cuando el servicio que se abandona monetiza datos de comportamiento, comparte información con terceros para publicidad dirigida o utiliza contenido del usuario para entrenamiento de IA sin consentimiento diferenciado. En esos escenarios, ajustar configuraciones internas resuelve solo una parte del problema: mientras la cuenta permanece activa, el historial de datos sigue disponible para el operador. La migración, en cambio, habilita una solicitud de eliminación de cuenta y datos asociados que —al menos en jurisdicciones con regulación vigente— el responsable tiene la obligación legal de atender.

    Sin embargo, migrar no es suficiente cuando el servicio alternativo no está sujeto a ningún marco regulatorio claro o cuando carece de política de privacidad auditada. Muchas herramientas de código abierto o descentralizadas ofrecen mejores condiciones de privacidad en términos técnicos, pero no tienen domicilio legal en ningún país, lo que dificulta el ejercicio de derechos ante una autoridad de control. En esos casos, el usuario gana autonomía técnica pero pierde respaldo jurídico. La evaluación debe ser caso por caso.

    El ángulo organizacional: cuando la migración involucra datos de empleados y clientes

    Para empresas y organismos públicos en América Latina, la discusión sobre alternativas tecnológicas no es solo de preferencia individual: involucra datos personales de terceros. Una organización que utiliza herramientas de productividad de un hiperescalador y activa funciones de IA generativa sobre documentos internos puede estar transfiriendo datos personales de empleados o clientes a un sistema de entrenamiento sin base legal suficiente. Las autoridades de protección de datos de la región —la AAIP en Argentina, la ANPD en Brasil, el INAI en México— han señalado en distintos pronunciamientos que la incorporación de IA en tratamientos existentes puede requerir una nueva evaluación de impacto o incluso actualizar el aviso de privacidad.

    La iniciativa de la EFF no está dirigida a equipos legales ni a DPOs, pero el principio que la sustenta —revisar activamente si las herramientas en uso son compatibles con los derechos de las personas sobre sus datos— es exactamente el ejercicio que cualquier programa de privacidad corporativa debería realizar de forma periódica. Opt Out October, en ese sentido, funciona como un recordatorio calendárico para lo que en el ámbito organizacional se llama privacy review o revisión del inventario de tratamientos.

    El hub de recursos de Opt Out October de la EFF está disponible en eff.org; para el contexto regulatorio aplicable en la región, las autoridades de referencia son la ANPD (Brasil), la AAIP (Argentina) y el INAI (México), cuyos sitios publican guías sobre ejercicio de derechos y obligaciones de los responsables de tratamiento.

  • Utah SB 73: un juez federal bloquea la ley antiVPN por imposibilidad técnica

    Utah SB 73: un juez federal bloquea la ley antiVPN por imposibilidad técnica

    Un juez federal de Utah emitió una medida cautelar que suspende la aplicación de la SB 73, la ley estatal que exigía a sitios web adultos bloquear a usuarios de VPN o identificar su ubicación física. La decisión, que la Electronic Frontier Foundation (EFF) celebró como un triunfo para los derechos digitales, establece que la norma probablemente viola la Constitución estadounidense al imponer una obligación técnicamente imposible de cumplir. El fallo tiene implicancias directas para el debate latinoamericano sobre verificación de edad y regulación de plataformas.

    Qué ordenaba la SB 73 de Utah y por qué era inviable

    Sancionada a principios de 2026 y firmada por el gobernador de Utah, la SB 73 convirtió a ese estado en el primero del país —según el propio registro de la EFF— en apuntar directamente al uso de VPN como mecanismo para eludir controles de verificación de edad en plataformas de contenido adulto. La ley exigía a los sitios web dos alternativas igualmente problemáticas: bloquear completamente a cualquier usuario que accediera mediante una VPN, o bien identificar la ubicación física real de ese usuario a pesar del enmascaramiento de tráfico que la herramienta provee. Para cerrar el círculo, la norma también prohibía a las plataformas publicar instrucciones sobre cómo usar una VPN para eludir esos controles.

    El tribunal federal suspendió la aplicación de las disposiciones sobre VPN con un argumento central: la ley probablemente viola la cláusula constitucional que impide al gobierno imponer cargas significativas sobre actividades comerciales interestatales. Pero el argumento técnico fue igualmente contundente. Detectar con certeza si un usuario está detrás de una VPN —y más aún identificar su ubicación real— no es un problema de recursos o de voluntad regulatoria: es una imposibilidad técnica en el estado actual de la infraestructura de internet, tal como argumentó la EFF en sus comentarios ante el Departamento de Comercio de Utah.

    La EFF ante el Departamento de Comercio de Utah: privacidad como argumento técnico y de derechos

    Simultáneamente al fallo judicial, la EFF presentó comentarios formales en el proceso de elaboración de reglas del Departamento de Comercio de Utah, donde detalló cómo forzar a las plataformas a detectar y bloquear herramientas de privacidad no solo es técnicamente inviable, sino que compromete la seguridad de usuarios en todo el mundo. Las VPN son utilizadas por periodistas, activistas, trabajadores remotos y ciudadanos en regímenes autoritarios, y cualquier infraestructura diseñada para identificar a sus usuarios crea un vector de vulnerabilidad que va mucho más allá del contexto regulatorio de Utah.

    Verificación de edad en plataformas: el mapa regulatorio en Brasil, Argentina y México

    El caso de Utah no es un fenómeno aislado. La regulación de contenidos digitales para menores y la verificación de edad en plataformas es un debate activo en América Latina, con distintos niveles de avance según el país. En Brasil, la Lei 14.811/2024 refuerza la protección de niñas, niños y adolescentes en entornos digitales y habilita a la Autoridade Nacional de Proteção de Dados (ANPD) para intervenir en casos de tratamiento indebido de datos de menores, aunque la regulación específica sobre verificación de edad en plataformas de contenido adulto aún está en desarrollo. El Marco Legal da IA, aprobado en 2024, también incorpora principios que impactarán en cómo las plataformas gestionan el acceso diferenciado por edad.

    En Argentina, la Ley 25.326 de Protección de Datos Personales no contempla explícitamente mecanismos de verificación de edad en plataformas digitales, y el proyecto de reforma que tramita en el Congreso tampoco ha incorporado ese eje de manera específica. La Agencia de Acceso a la Información Pública (AAIP) tiene competencia sobre el tratamiento de datos de menores, pero carece de un mandato claro sobre verificación de acceso a contenidos. En México, la LFPDPPP tampoco cubre este escenario, aunque el Instituto Nacional de Transparencia, Acceso a la Información y Protección de Datos Personales (INAI) ha emitido criterios sobre el tratamiento de datos de menores que podrían ser relevantes si una regulación similar a la SB 73 intentara replicarse a nivel federal o estatal.

    El patrón regional es claro: ningún país latinoamericano ha legislado todavía sobre la obligación de bloquear VPN como mecanismo de verificación de edad, pero la presión regulatoria sobre plataformas de contenido adulto es creciente en varios congresos. El fallo de Utah provee un antecedente jurisprudencial relevante sobre los límites técnicos y constitucionales de ese enfoque.

    Qué cambia para plataformas que operan en la región si este modelo regulatorio avanza

    Para una empresa de tecnología o una plataforma de contenidos con usuarios en América Latina, el escenario regulatorio emergente plantea tres desafíos concretos. Primero, cualquier obligación de verificación de edad que implique identificar o bloquear usuarios de VPN requeriría infraestructura de detección de tráfico que, según el argumento técnico validado por el tribunal de Utah, no existe de forma confiable. Segundo, implementar esa infraestructura —aunque fuera posible— crearía riesgos de privacidad para todos los usuarios, no solo para quienes intentan evadir controles, en directa tensión con las obligaciones de las leyes de protección de datos personales vigentes en la región. Tercero, las plataformas que operen en múltiples jurisdicciones se enfrentan a estándares contradictorios: una regulación en un estado o país puede exigir lo que otra prohíbe.

    Próximos hitos: el litigio sigue y los congresos de la región observan

    La medida cautelar es preliminar: el litigio sobre la SB 73 continuará en los tribunales federales de Utah. Una decisión definitiva sobre la inconstitucionalidad de la norma —o su eventual reformulación— marcará el terreno para regulaciones similares en otros estados de EE.UU. y, por efecto de influencia regulatoria, en países de América Latina que suelen mirar los debates legislativos norteamericanos como referencia. Vale monitorear también la evolución del Marco Legal da IA en Brasil y las discusiones en el Congreso argentino sobre reforma de la ley de datos personales, ambos espacios donde la regulación de acceso por edad podría aparecer como enmienda o artículo separado.

    Nuestro análisis

    El fallo de Utah pone en evidencia una tensión estructural que los legisladores latinoamericanos deberían leer con atención: la presión política por regular el acceso de menores a contenido adulto es legítima, pero el instrumento técnico importa tanto como la intención normativa. Obligar a las plataformas a detectar VPN no es una exigencia de compliance riguroso, es pedirle al derecho que derogue la criptografía. El mismo error conceptual reaparece en debates regionales sobre retención de datos, acceso gubernamental a comunicaciones cifradas y geolocalización forzada. El antecedente judicial estadounidense no es vinculante para los tribunales de la región, pero sí es un argumento técnico documentado y respaldado por un órgano jurisdiccional, lo que le otorga peso en cualquier proceso de elaboración de normas. Las autoridades de protección de datos de la región —ANPD, AAIP, INAI— tienen aquí una oportunidad concreta de emitir criterios preventivos antes de que algún legislador intente replicar la SB 73 en español.

    Cuando una ley exige lo técnicamente imposible, el problema no lo resuelve el cumplimiento: lo resuelve el control judicial. ¿Están las autoridades regulatorias de América Latina equipadas para hacer ese análisis técnico antes de que una norma inviable entre en vigor?

  • El consentimiento obligado a la IA duplica al genuino, y LATAM no lo mide

    El consentimiento obligado a la IA duplica al genuino, y LATAM no lo mide

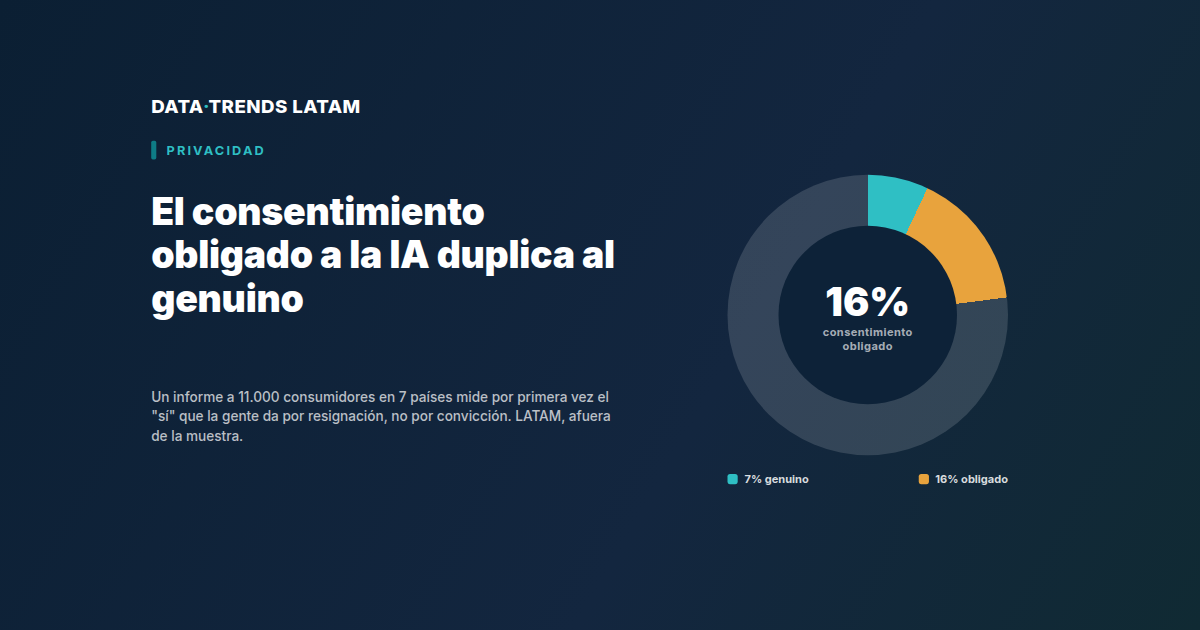
    Siete de cada diez consumidores en Alemania, España, Italia, Países Bajos, Suecia, Estados Unidos y Reino Unido dicen que le darían a un asistente de inteligencia artificial (IA) acceso a datos sensibles: sus herramientas de trabajo, su información de salud, los datos de su cuenta en la empresa. El problema aparece cuando se mira cómo llegan a ese sí. Solo el 7% está totalmente cómodo con esa decisión; otro 16% dice que sí mientras reconoce sentirse incómodo. Es más del doble.

    A esa segunda categoría, el informe The Resigned Consent Report —parte del State of Digital Trust 2026 de Usercentrics y Cookiebot, basado en una encuesta a 11.000 personas en siete mercados realizada por Sapio Research en marzo de 2026, con un margen de error de ±0,9% al 95% de confianza— la llama “consentimiento obligado” (resigned consent en el original en inglés, literalmente “consentimiento resignado”): una autorización que en las métricas de adopción se ve idéntica a un sí genuino, pero que se comporta distinto en cuanto algo sale mal.

    Qué mide el informe y por qué una tasa de consentimiento no alcanza

    Una tasa de autorización le dice a una empresa cuánta gente dijo que sí. No le dice qué tipo de sí recibió. Esa distinción es el eje regulatorio de fondo: tanto el Reglamento General de Protección de Datos (RGPD) de la Unión Europea como la mayoría de las leyes de protección de datos de América Latina exigen que el consentimiento sea libre, informado, específico e inequívoco. Un “sí” que la persona da porque ya decidió que negarse no era una opción real —la definición operativa de consentimiento obligado que usa el informe— es, en rigor, un consentimiento que no cumple con el estándar de ser “libremente otorgado” que exige ese marco legal, aunque en el dato agregado luzca igual que cualquier otro.

    En promedio, el 58% de los consumidores encuestados reporta algún nivel de incomodidad con que la IA acceda a sus datos, en un rango que va del 53% para herramientas de trabajo al 64% para cuentas financieras, medido en seis categorías:

    Categoría Cómodo sin condiciones Algo de incomodidad (total) Incómodo, lo permite igual Dejaría de usar la IA
    Cuentas financieras 6% 64% 14% 24%
    Archivos/documentos 6% 59% 15% 19%
    Datos de la empresa 8% 57% 16% 16%
    Datos de salud 8% 57% 17% 15%
    Email/calendario 8% 55% 17% 15%
    Herramientas de trabajo 8% 53% 17% 13%

    El patrón es contraintuitivo: donde el riesgo percibido es más alto —cuentas financieras—, el consentimiento obligado es el más bajo (14%) porque la gente directamente se va (24% dejaría de usar la IA por completo). Donde el riesgo percibido es más bajo y el pedido es más frecuente —herramientas de trabajo, email, salud—, el consentimiento obligado llega a su pico (17%). El informe conecta ese patrón con lo que la investigación en diseño llama “fatiga de consentimiento”: cuanto más seguido se repite el mismo tipo de pedido, menos lo procesa activamente quien lo recibe, aunque la incomodidad de fondo no desaparezca.

    Por qué le importa a una empresa que opera en América Latina

    Para una empresa que despliega copilotos o agentes de IA internos —el escenario de “herramientas de trabajo”, que el informe identifica como el de mayor adopción real y también el de mayor consentimiento obligado—, el riesgo no es solo de experiencia de usuario. Tilman Harmeling, de Strategy & Market Intelligence en Usercentrics, lo resume así en el informe: “Un sí obligado y uno real son idénticos en tu tasa de consentimiento, pero se comportan de manera completamente distinta. Uno se sostiene bajo presión. El otro se sostiene hasta el primer titular negativo. Si no podés distinguir cuál de los dos tenés, no sabés cuánta de tu adopción de IA es realmente tuya” (traducción propia).

    Esa “primera crisis” es, en términos legales, el momento en el que un regulador o un tribunal revisa si el consentimiento que respalda un tratamiento de datos fue realmente válido. Una brecha de datos, un cambio en los términos de privacidad o una función que silenciosamente amplía lo que la IA puede acceder son, todos, escenarios en los que ese “sí” obligado deja de sostenerse —y ahí es donde se mide si hubo consentimiento genuino o una autorización de cumplimiento mínimo.

    Marco comparado: qué exigen las leyes de protección de datos en la región

    Ninguno de los siete mercados relevados por el informe es latinoamericano, pero el estándar legal de fondo —libertad, información y especificidad del consentimiento— sí tiene equivalentes concretos en la región:

    Argentina regula el tratamiento de datos personales bajo la Ley 25.326 de Protección de Datos Personales, que exige consentimiento “libre, expreso e informado” (artículo 5). La Agencia de Acceso a la Información Pública (AAIP) impulsó un anteproyecto de reforma integral de la ley, con estándares más exigentes de consentimiento para perfilamiento y decisiones automatizadas; [VERIFICAR el estado parlamentario actual del proyecto, dado que no forma parte de las fuentes de este informe].

    Brasil exige bajo la Lei Geral de Proteção de Dados (LGPD, Lei 13.709/2018) que el consentimiento sea “livre, informado e inequívoco” (artículo 7°, inciso I), y su autoridad de control, la Autoridade Nacional de Proteção de Dados (ANPD), avanzó en regulación específica sobre tratamiento automatizado de datos y derecho a explicación frente a decisiones de IA; [VERIFICAR el texto vigente de esa resolución y su alcance actual].

    México reformó en 2025 su marco de protección de datos con una nueva Ley General de Protección de Datos Personales en Posesión de Sujetos Obligados, en el contexto de la disolución del Instituto Nacional de Transparencia (INAI) y el traspaso de sus funciones de tutela de datos a un organismo de la administración centralizada; [VERIFICAR el nombre exacto del organismo garante vigente y el estado de la normativa aplicable al sector privado].

    En los tres casos, el estándar legal no pregunta cuántas personas dijeron que sí: pregunta si ese sí fue libre. Es la misma pregunta que el informe de Usercentrics y Cookiebot plantea para el consumidor promedio en Europa y Estados Unidos, y que ningún regulador de la región ha medido todavía de forma específica para IA.

    Qué monitorear

    No hay, por ahora, una resolución o guía de una autoridad de datos latinoamericana que mida específicamente la “calidad” del consentimiento otorgado a sistemas de IA en los términos que usa este informe. Lo que sí hay, y vale seguir de cerca, es la convergencia de dos procesos: por un lado, el avance de los marcos de IA y de reforma de protección de datos en Argentina, Brasil y México citados arriba; por el otro, la adopción creciente de agentes de IA en entornos corporativos de la región, que replica casi exactamente el escenario de “herramientas de trabajo” donde el informe mide el pico de consentimiento obligado (17%).

    Para un DPO o un equipo legal que gestiona el rollout de IA en la región, el informe ofrece cuatro criterios de diseño de producto que son, también, criterios de robustez legal del consentimiento: dar el mismo peso visual a aceptar, rechazar y personalizar; permitir elegir por categoría de dato y no en bloque; hacer que rechazar cueste lo mismo que aceptar; y pedir el acceso en el momento en que es relevante, no por adelantado. Un consentimiento diseñado así es, además de mejor experiencia, más defendible ante una autoridad de control.

    Nuestro análisis

    El dato más incómodo del informe no es el 16% de consentimiento obligado global: es que esa cifra no aparece en ningún tablero de adopción. Un rechazo se registra como rechazo. Un abandono se registra como churn. Un consentimiento obligado se registra, simplemente, como un sí. Es la única forma de incomodidad del consumidor que hoy entra a las métricas de éxito de una empresa disfrazada de resultado positivo.

    Eso tiene una lectura regional directa. América Latina no estuvo en la muestra, pero sus marcos legales comparten con el RGPD europeo la misma exigencia de fondo —consentimiento libre e informado— y sus empresas están adoptando IA en el mismo tipo de categorías (herramientas de trabajo, email, datos de la empresa) donde el informe mide el mayor consentimiento obligado. No hace falta un dato propio de la región para anticipar que el patrón se repite: hace falta que una autoridad de control, un incidente de seguridad o una demanda colectiva lo pongan en evidencia, como ya ocurrió en otros frentes de cumplimiento de IA en la región.

    Cierre

    El informe cierra con una frase que vale como pregunta para cualquier empresa que mida su “tasa de IA” como un éxito: las marcas a las que los consumidores les darán acceso en 2027 son las que están decidiendo, hoy, cómo piden ese acceso. La pregunta que ninguna tasa de consentimiento responde por sí sola es si ese “sí” se sostiene el día que algo se rompe.

    Preguntas frecuentes

    ¿Qué es el “consentimiento obligado” según el informe de Usercentrics y Cookiebot?
    Es la autorización que una persona da para que la IA acceda a sus datos pese a sentirse incómoda con esa decisión, porque considera que negarse no es una opción real. El informe lo mide con el doble de frecuencia (16%) que el consentimiento totalmente cómodo (7%).

    ¿Las leyes de protección de datos de América Latina exigen que el consentimiento sea “libre” y no solo formal?
    Sí. La Ley 25.326 en Argentina y la LGPD en Brasil, entre otras normas de la región, exigen expresamente que el consentimiento sea libre, informado y específico, el mismo estándar que el informe usa para distinguir un “sí” genuino de uno obligado.

    ¿Qué puede hacer una empresa para reducir el riesgo de que su consentimiento sea “obligado” y no genuino?
    El informe recomienda dar el mismo peso visual a aceptar y rechazar, permitir el consentimiento granular por categoría de dato, igualar la fricción de optar por no participar con la de aceptar, y pedir el acceso en el momento en que es efectivamente relevante para el usuario.

    Fuente primaria: Usercentrics x Cookiebot, The Resigned Consent Report (State of Digital Trust 2026), marzo de 2026, Sapio Research, 11.000 encuestados en 7 mercados.

  • Registros municipales de McMinnville quedaron expuestos en línea sin protección

    Registros municipales de McMinnville quedaron expuestos en línea sin protección

    Un especialista en ciberseguridad detectó que registros sensibles del municipio de McMinnville, Oregon, estaban accesibles públicamente en línea sin ningún control de acceso. Según se informó, los archivos expuestos incluían información personal de residentes y fueron descriptos por el investigador como “un tesoro de información”.

    El hallazgo fue reportado por KOIN.com a partir de la alerta de un especialista en ciberseguridad que identificó los registros municipales expuestos. No se precisó en la información disponible cuánto tiempo estuvieron accesibles los archivos ni si terceros no autorizados accedieron a ellos antes de que el problema fuera detectado. La ciudad de McMinnville no había emitido una declaración pública confirmada al momento del reporte.

    Datos confirmados sobre la exposición

    • Actor afectado: municipio de McMinnville, Oregon, Estados Unidos.
    • Tipo de datos: registros municipales sensibles con información personal de residentes, según se informó.
    • Método de detección: alerta de un especialista externo en ciberseguridad.
    • Acceso no autorizado confirmado: no verificado al momento de la publicación.
    • Fecha de reporte público: 1 de octubre de 2025.

    Qué se sabe y qué falta confirmar

    Lo confirmado es que los registros estaban disponibles en línea sin restricciones de acceso y que el problema fue identificado por un tercero, no por el propio municipio. Lo que permanece sin confirmar incluye el volumen exacto de registros expuestos, el período de exposición, la naturaleza precisa de los datos comprometidos y si hubo descarga o exfiltración por parte de actores maliciosos. Tampoco se ha informado si el municipio notificó formalmente a los ciudadanos afectados ni bajo qué marco legal deberá hacerlo.

    En términos de gobernanza, el incidente ilustra una falla en la clasificación y el control de acceso sobre activos de datos públicos: el dato estaba accesible porque nadie tenía asignada la responsabilidad de garantizar que no debía estarlo. En organismos equivalentes de América Latina, este tipo de exposición activaría obligaciones de notificación bajo marcos como la Ley 25.326 en Argentina —que exige comunicar a la Agencia de Acceso a la Información Pública (AAIP) ante incidentes que afecten bases de datos registradas— o la Lei Geral de Proteção de Dados (LGPD) en Brasil, que establece plazos de notificación a la Autoridade Nacional de Proteção de Dados (ANPD) en un máximo de dos días hábiles desde el conocimiento del incidente cuando existe riesgo relevante.

    El próximo hito crítico es la determinación oficial por parte del municipio de McMinnville sobre si existió exfiltración, dato que definirá si se activan obligaciones formales de notificación a los residentes afectados.

  • Baterías distribuidas: regulación, redes eléctricas y el modelo que llega a LATAM

    Baterías distribuidas: regulación, redes eléctricas y el modelo que llega a LATAM

    Las baterías de almacenamiento energético a gran escala enfrentan en muchas ciudades un laberinto regulatorio que frena su despliegue. Frente a esa barrera, startups en Estados Unidos están apostando por un modelo alternativo: baterías pequeñas, distribuidas y ubicadas en lugares no convencionales. El modelo tiene implicancias directas para los marcos regulatorios de energía en América Latina.

    El almacenamiento de energía es uno de los cuellos de botella más citados en la transición hacia redes eléctricas más limpias y resilientes. En teoría, las baterías permiten guardar energía cuando la generación es abundante y liberarla cuando la demanda pica. En la práctica, instalar un sistema de almacenamiento de gran escala en un entorno urbano denso —como Nueva York— puede implicar años de trámites, aprobaciones sectoriales superpuestas y costos regulatorios que hacen inviable el proyecto antes de que se tienda un cable.

    El problema de Nueva York y qué lo hace un caso de estudio regulatorio

    Nueva York es un ejemplo extremo, pero no una anomalía. La ciudad concentra regulaciones de zonificación, seguridad contra incendios, normativas del operador de red y requisitos ambientales que, según se informó, convierten la habilitación de grandes baterías urbanas en un proceso excepcionalmente complejo. Ese entorno hostil empujó a algunas empresas emergentes a repensar la arquitectura del problema: en lugar de una batería grande que negocia con el sistema, muchas baterías pequeñas que operan de forma coordinada y que, individualmente, caen por debajo de los umbrales que activan los controles más estrictos.

    El enfoque no es solo una ingeniería alternativa. Es también una estrategia regulatoria. Si los marcos normativos están escritos para instalaciones de cierta escala, diseñar por debajo de esa escala es, en la práctica, arbitrar la regulación. Eso abre preguntas sobre si las normas vigentes están capturando adecuadamente el riesgo real del sistema o si, al fragmentarlo, se crea un vacío de supervisión.

    Cuándo aplica el modelo distribuido y cuándo no

    El almacenamiento distribuido tiene ventajas concretas: reduce pérdidas de transmisión, aporta resiliencia local ante cortes y puede integrarse en edificios, estacionamientos o instalaciones industriales sin requerir obra civil mayor. Sin embargo, no es una solución universal. La coordinación de cientos o miles de unidades pequeñas requiere software de gestión sofisticado, acuerdos contractuales con múltiples propietarios de activos y protocolos de interoperabilidad que muchas redes de distribución en la región aún no tienen implementados. Donde la red de distribución es débil o donde falta infraestructura de comunicaciones, el modelo pierde eficiencia rápidamente.

    Argentina, Brasil y México: tres marcos regulatorios con diferente punto de partida

    En América Latina, el almacenamiento energético es una frontera regulatoria abierta. Brasil avanzó con la Resolución Normativa 1.059 de ANEEL (2023), que estableció el marco para el almacenamiento conectado a la red, pero la regulación de sistemas distribuidos de pequeña escala sigue en desarrollo. En Argentina, el Ente Nacional Regulador de la Electricidad (ENRE) no cuenta aún con un marco específico para almacenamiento domiciliario o comercial conectado a la red de distribución, lo que deja a los proyectos piloto en una zona gris. México, por su parte, atraviesa una etapa de redefinición de su política energética que ha generado incertidumbre sobre las reglas de despacho para fuentes no convencionales, incluyendo el almacenamiento.

    Chile es, quizás, el caso más avanzado de la región: la Ley de Almacenamiento y Electromovilidad (Ley 21.505, promulgada en 2022) creó una categoría regulatoria específica para sistemas de almacenamiento y habilitó su participación en el mercado eléctrico. Ese marco es el tipo de habilitador que las startups de almacenamiento distribuido necesitan para operar a escala, y que aún falta en la mayoría de los países del cono sur.

    El arbitraje regulatorio como señal de alerta para los reguladores

    Que las empresas diseñen sus instalaciones para quedar por debajo de los umbrales regulatorios no es necesariamente ilegal ni reprochable, pero sí es una señal que los reguladores deberían leer con atención. Indica que las normas existentes están generando incentivos no previstos. En el sector financiero, ese tipo de arbitraje regulatorio suele anunciar la necesidad de una revisión de los umbrales y definiciones. En el sector energético, el patrón podría repetirse: si muchas instalaciones de 999 kWh evitan las exigencias pensadas para instalaciones de 1 MWh, la política pública no está logrando su objetivo.

    Para los organismos reguladores de energía en la región, el caso estadounidense es un aviso temprano. Diseñar marcos que capturen el riesgo sistémico del almacenamiento distribuido —no solo el de cada unidad individual— será uno de los desafíos centrales de la próxima década regulatoria.

    La Ley chilena 21.505 es, hoy, el único modelo regional con categoría regulatoria explícita para almacenamiento: el resto de la región tiene poco tiempo para observar qué funciona antes de que el despliegue tecnológico supere a las normas.

  • Anti-SLAPP en California: un fallo que protege el periodismo de vigilancia

    Anti-SLAPP en California: un fallo que protege el periodismo de vigilancia

    Un tribunal de apelaciones de California confirmó el rechazo de una demanda interpuesta por el ex CEO de una empresa de tecnología de vigilancia contra el periodista que reveló su arresto por violencia doméstica. El fallo refuerza la vigencia del estatuto anti-SLAPP de California y la Ley de Escudo periodístico del estado, con implicancias directas para el debate regulatorio en América Latina sobre demandas estratégicas contra la prensa.

    Jack Poulson, escritor y editor del boletín All Source Intelligence, publicó detalles del informe policial del Departamento de Policía de San Francisco sobre el arresto de Maury Blackman —entonces CEO de Premise Data, una compañía especializada en inteligencia geoespacial con contratos militares— por un delito grave de violencia doméstica. Poulson obtuvo el documento de una fuente confidencial. Cuando el expediente judicial fue sellado con posterioridad a la publicación, Blackman demandó a Poulson, a Substack, a Amazon Web Services y a otra organización, reclamando daños y la eliminación del contenido de internet.

    Cómo funciona el anti-SLAPP de California: desestimación temprana antes del juicio

    El tribunal de primera instancia desestimó la totalidad del caso bajo el estatuto anti-SLAPP de California. Las siglas SLAPP corresponden a “strategic lawsuit against public participation” —demanda estratégica contra la participación pública— y describen litigios cuyo objetivo real no es obtener una reparación judicial sino imponer costos económicos, de tiempo y de estrés al demandado para silenciar su actividad. La legislación anti-SLAPP de California permite la desestimación anticipada de estas demandas infundadas, cortando de raíz el efecto intimidatorio que buscan generar. Blackman apeló, argumentando que la orden judicial de sellado del expediente de arresto primaba sobre el derecho de Poulson a informar sobre hechos de interés público.

    El Tribunal de Apelaciones rechazó ese argumento. En su decisión, el tribunal señaló que la Primera Enmienda protege la publicación veraz de información obtenida lícitamente, salvo que exista “la necesidad de promover un interés estatal de la más alta jerarquía” —un estándar que, según el tribunal, el interés de privacidad de Blackman no satisface. El fallo también confirmó que Poulson está protegido por la Shield Law de California como editor de un boletín periodístico, apoyándose en precedente establecido por la Electronic Frontier Foundation (EFF) en 2006. Substack y los demás sitios que alojaban el contenido también quedaron amparados por haber actuado simplemente como plataformas de publicación.

    El CEO de una empresa de vigilancia intentó silenciar con el proceso lo que no pudo borrar del registro

    El caso tiene una dimensión adicional que va más allá del derecho de prensa: el demandante no era un particular anónimo sino el máximo ejecutivo de una empresa cuyo modelo de negocio es, precisamente, la recolección y el análisis de datos de inteligencia. Premise Data ha sido señalada en investigaciones periodísticas previas por sus vínculos con contratos militares y el uso de redes de colaboradores civiles para mapear entornos de interés geopolítico. Que el CEO de una compañía de ese perfil intentara suprimir información de interés público sobre su propia conducta personal mediante una demanda civil configura un uso del sistema judicial especialmente incongruente con el debate público legítimo que rodea a la industria de vigilancia.

    Argentina, México y Colombia carecen de estatutos anti-SLAPP equivalentes al californiano

    En América Latina, las demandas estratégicas contra periodistas y activistas constituyen un patrón documentado, pero la respuesta legislativa es fragmentaria. Argentina no cuenta con un mecanismo de desestimación anticipada equivalente al anti-SLAPP californiano; la protección del periodismo frente a demandas abusivas depende en gran medida de la doctrina de la real malicia construida por la Corte Suprema a partir del caso “Campillay” (1986) y sus derivados, que exige probar dolo o negligencia grave del periodista para atribuir responsabilidad civil. Sin embargo, esa doctrina no impide que el proceso mismo —con sus costos y plazos— funcione como mecanismo de presión.

    México presenta una situación similar: si bien el artículo 7 de la Constitución garantiza la libertad de imprenta, no existe un mecanismo procesal que permita el rechazo in limine de demandas identificadas como estratégicas. En Colombia, la Ley 1564 de 2012 (Código General del Proceso) habilita algunas herramientas de saneamiento temprano, pero no están diseñadas específicamente para litigios contra la prensa. Chile avanzó con la Ley 21.394 de 2021 en materia de reforma procesal civil, pero tampoco incorporó disposiciones anti-SLAPP explícitas. La Relatoría Especial para la Libertad de Expresión de la CIDH ha señalado en múltiples informes que la litigación abusiva es uno de los vectores de censura indirecta más extendidos en la región.

    Shield Laws y fuentes confidenciales: el vacío que persiste en las legislaciones latinoamericanas

    El fallo también ratifica la vigencia de la Shield Law de California, que protege a los periodistas de revelar sus fuentes confidenciales. En LATAM, la protección del secreto de las fuentes tiene reconocimiento constitucional en varios países —Argentina (art. 43 CN), Colombia (art. 73 CN) y México (art. 7 CPEUM)—, pero su alcance en entornos digitales y plataformas de publicación independiente como Substack no ha sido objeto de desarrollo jurisprudencial sistemático. La pregunta de si un editor de newsletter cuenta con la misma protección que un periodista de medio tradicional es, en la mayoría de los sistemas jurídicos latinoamericanos, una pregunta sin respuesta clara.

    Nuestro análisis: el anti-SLAPP no es un privilegio de prensa sino una garantía de equilibrio procesal

    El fallo californiano no crea derechos nuevos: los consolida frente al intento de erosionarlos mediante la presión litigiosa. Lo relevante para la región no es el resultado —favorable al periodismo— sino el mecanismo: una vía procesal que permite cortar temprano una demanda identificada como estratégica, antes de que el costo del proceso logre su objetivo real. En ausencia de herramientas equivalentes, los sistemas jurídicos latinoamericanos quedan expuestos a un déficit estructural: la tutela sustantiva de la libertad de expresión existe en el papel, pero el proceso puede convertirse en el castigo. Que el demandante sea el ex CEO de una empresa de vigilancia agrega una ironía difícil de ignorar: la industria que recolecta datos sobre terceros intentó suprimir datos verificados sobre sí misma.

    Mientras la región debate leyes de protección de datos personales y marcos de regulación de plataformas, el instrumento que hace falta en la mayoría de los códigos procesales latinoamericanos es más mundano y más urgente: una vía para detener, antes del primer año de litigio, la demanda que no busca justicia sino silencio.